Harness Engineering:从零讲清楚
来源:santi 在 X 上
一年前,如果你问别人如何改进一个 Agent,答案几乎总是一样的:换个模型,或者写一段更好的提示词。
但那只是一部分。我想给你展示为什么:
OpenAI 构建了一整个内部产品:一百万行代码、1500 个 pull request,而没有任何人类写过一行代码。
LangChain 把它自己的编码 Agent 从 Terminal Bench 2.0 的第 30 名带到了前 5 名。而它并没有更换模型。
Anthropic 记录了类似的事情:同一个模型,在不同的配置下,可能给你留下一个看起来不错却跑不起来的应用,也可能给你留下一个真正能用的应用。
这三者没有一个是通过更换模型做到的。三者都投资在了同一件事上:围绕模型的那个系统。
而这恰恰开始被称作 Harness Engineering。
他们到底构建了什么?
这就是我们在这里要从零搭起来的东西:我们从一个只会返回文本的模型开始,一次加一块,直到得到一个你可以把具体目标委派给它的 Agent。
但首先,我们需要理解模型与 harness 之间的区别。
模型做什么,harness 做什么
当你让一个编码 Agent(不管是 Claude Code、Codex 还是别的什么)去做一项任务时,你看到的只有一样东西:一段对话。你写下请求,Agent 就开始干活。它搜索文件、打开它们、写代码、跑测试,然后把改动展示给你。
看起来这一切都是模型做的。但实际上,模型只做了一部分:思考和决定该做什么。
一个模型接收文本并返回文本。这就是它做的全部。它不打开文件,不执行命令,也没有记忆。
但那么,如果不是模型,是谁在查找文件?是谁在写代码?一定还有另一个组件负责这些。
我们把这个组件称作 harness。
一个 harness,就是围绕模型的那个软件系统,它把模型写出来的东西变成完成的工作:它组装模型将要阅读的内容,解释模型的回应,执行模型要求的动作,保存过程中发生的事情,并判断任务何时完成。
说得更简短些:一切不是模型的东西,都是 harness。运行的程序、它提供的 tools、它执行这些工具的地方、它在一次调用与另一次调用之间保存的东西。所有这一切。
但模型只能写文本,它是怎么请求做一件事的呢?
harness 传给模型一份可用动作的清单:搜索代码、读取文件、编辑它、跑测试。这些动作叫做 tools。模型并不执行它们,它只写出想用哪一个,以及带什么参数。这个请求仍然是文本。harness 才把它转换成真实动作。
如果现在还没完全讲清楚,没关系。后面我们会用例子深入地看。目前有这个想法就够了:模型请求,harness 执行。
我们来看一个更实际的例子。
你正在构建一个可以发帖的应用,有点像 Twitter。你打开了仓库,所有代码都在里面。你想给帖子加上一个点赞按钮。于是你对 Agent 说:
「给帖子加一个点赞按钮。」
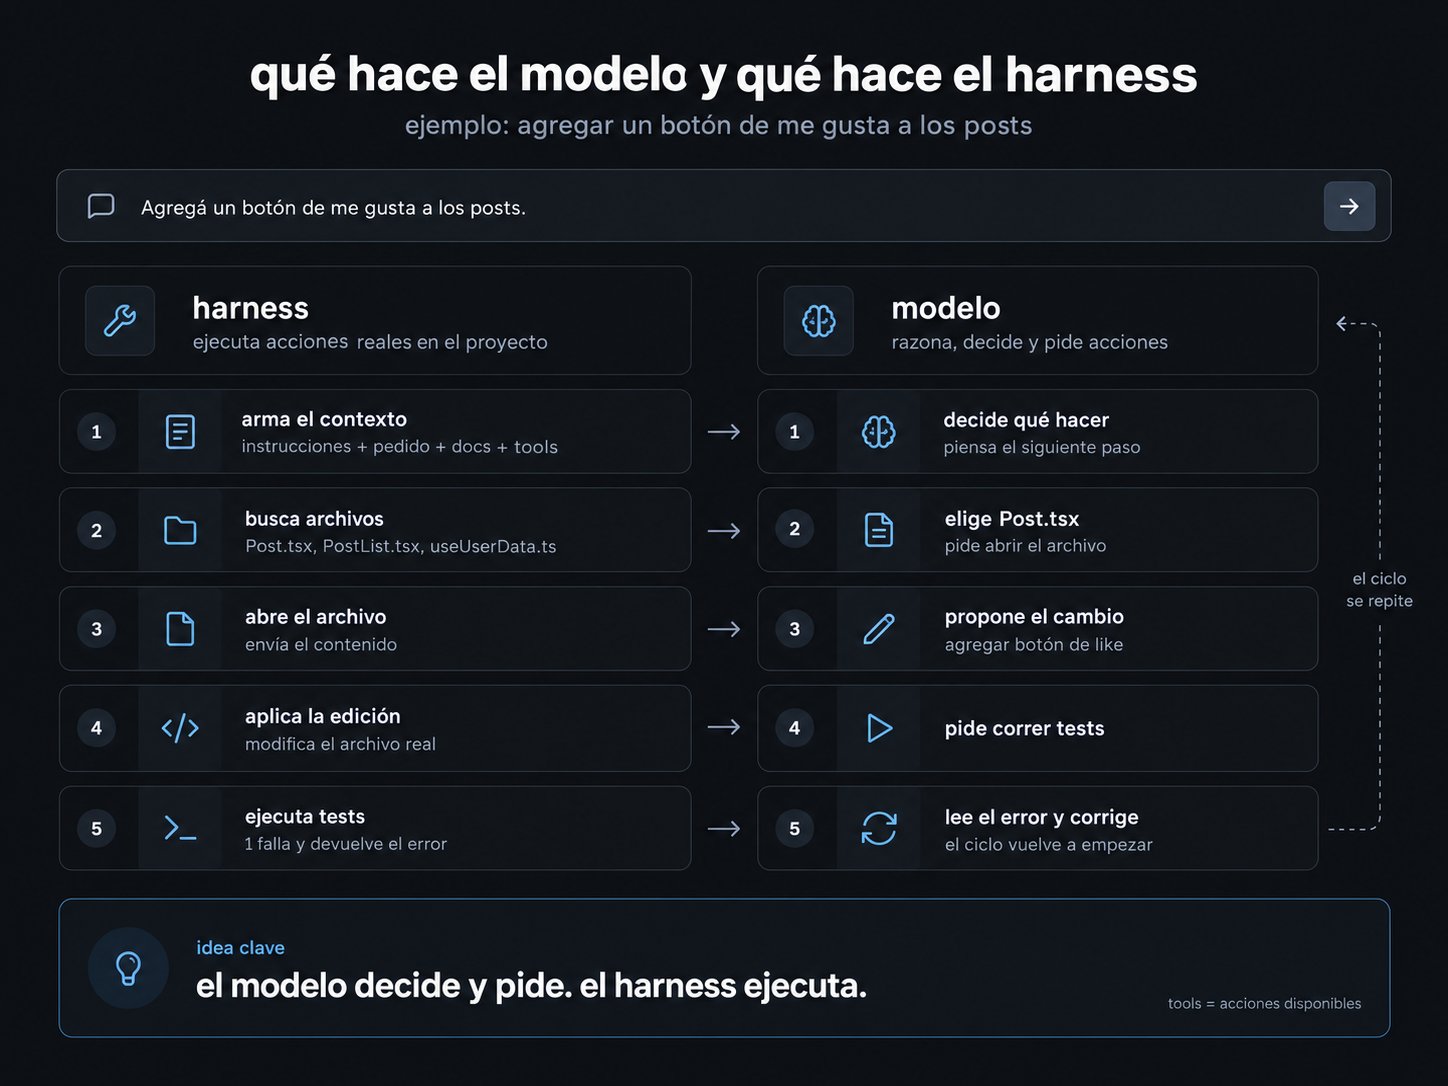
从这一刻起,接下来发生的是:
- harness 组装模型将收到的消息:关于它该怎么工作的指令、你的请求、项目关于自身的文档(团队约定、每样东西在哪里),以及带参数的可用 tools 清单。
- 模型 用文本回应:「我需要找到每个帖子在哪里渲染」,并请求使用搜索(tool)。
- harness 在你的真实文件上执行这次搜索,并返回三个文件:Post.tsx、PostList.tsx 和 useUserData.ts。(别在意这些名字,只是举例)
- 模型 判断按钮放在第一个文件里,并请求打开 Post.tsx。
- harness 打开它,并把内容发过去。
- 模型 提出改动:在这里、用这段代码加上按钮。
- harness 把它应用到真实文件上。
- 模型 请求跑测试。
- harness 跑测试并返回结果:其中一个失败了,连同错误信息。
- 模型 读取那个错误,并请求下一步改动。循环重新开始。
与此同时,你看到的只是 Agent 在工作。
注意这个模式:模型从不做任何事,它只是请求。harness 搜索、打开、编辑、执行,并把发生了什么返回给模型,好让模型能决定下一步。
这就是为什么这些工具感觉像是在一台电脑上工作的 Agent。模型提供推理。harness 把它与文件、终端、浏览器、数据库,或者任何它需要行动的环境连接起来。
具体落到实处:当你使用 Claude Code 时,模型是 Claude(Opus、Sonnet,随你选),而 Claude Code 是 harness。在 Codex 里也一样,Codex 是 harness,Sol 是模型。一个负责思考,另一个负责其余一切。
它们是你像别的程序一样安装并运行的程序。有意思的是它们内部有什么,而这恰恰就是我们现在要一步步搭起来的东西。
角色厘清之后,我们要一步步搭起一个 harness,以这同一个请求为目标:让 Agent 能加上点赞按钮,并且让你能相信它做对了。
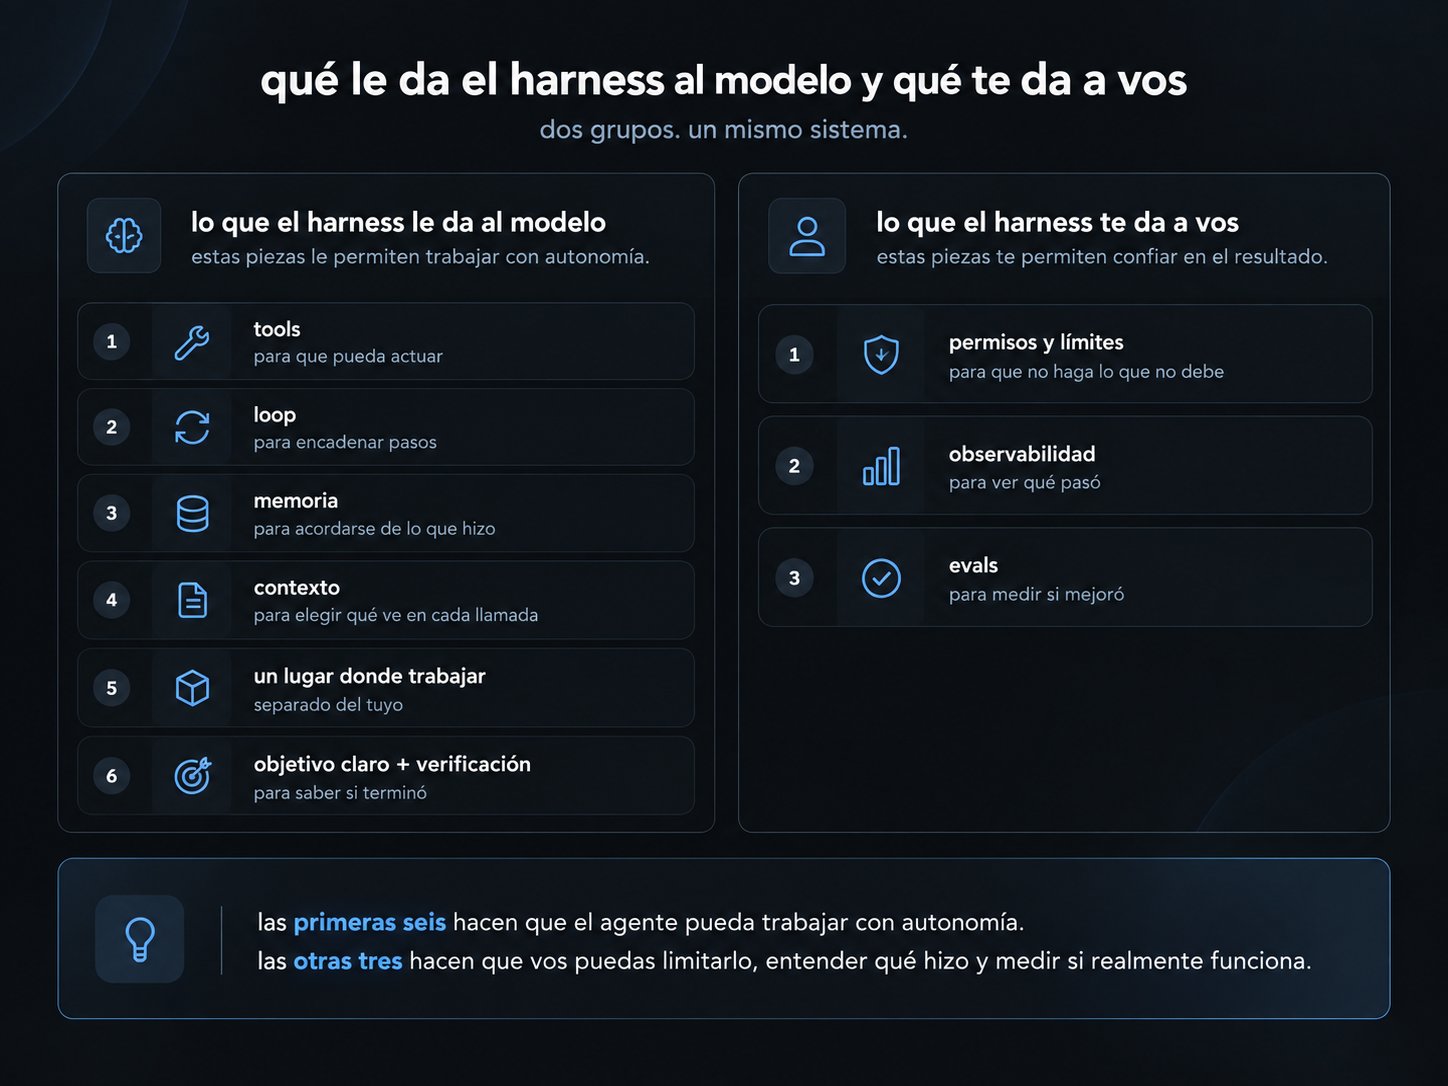
我们从一个单独的、只会返回文本的模型开始,一次加一块。一共九块,分成两组。
前六块是 harness 给模型的东西,好让它能完成工作:
- Tools,让它能行动。
- 一个 loop,用来串联步骤。
- 记忆,让它记得自己做过什么。
- 上下文,用来选择每次调用时它看到什么。
- 一个独立于你自己的工作场所。
- 一个清晰的目标和验证,用来知道它是否完成了。
另外三块是 harness 给你的东西,好让你能相信结果:
- 权限与边界,让它不做不该做的事。
- 可观测性,让你看到发生了什么。
- Evals,用来衡量它是否变好了。
这两组的区别很重要。前六块让 Agent 能自主工作并得到一个结果。另外三块让你能限制它、理解它做了什么,并衡量它是否真的有效。
harness 给模型的东西
1. Tools,让它能行动
回到那个请求:给帖子加上点赞按钮。
模型读了它,完美地理解了要做的事,并用文本回应:「应该在帖子的组件里加一个按钮」。
但你的仓库和之前一模一样。没有一个文件被打开,没有一行代码被写。
那么,如果它唯一能产出的就是文本,它要怎么去找到那个组件、打开它、并修改代码呢?
通过 tools。一个 tool 是 harness 提供给模型的一个函数:它有一个名字、一段说明它做什么的描述、它接收的参数,以及它返回的结果。harness 把可用 tools 的清单,以及模型请求它们时必须用的确切格式传给它。
对于我们的任务,我们给它 4 个:
buscar_codigo(texto)
leer_archivo(ruta)
editar_archivo(ruta, texto_viejo, texto_nuevo)
ejecutar_tests()
模型不能执行它们。它唯一能做的,是写出想用哪一个:
buscar_codigo("post")
这仍然是文本,但现在它有了一种 harness 能识别的形式。harness 读取它,在你的文件上执行搜索,并在下一次调用时把结果返回给它:
- components/Post.tsx
- components/PostList.tsx
- hooks/useUserData.ts
这一来一回就是全部机制:模型按一种约定的格式请求,harness 执行并回应。
这里有一点很重要:你如何设计这些 tools,会改变 Agent 的行为。让 editar_archivo 失败时只返回一个 error,和让它失败时说「我在 Post.tsx 里没找到那段文本,但在第 42 行有一处缩进不同的相似匹配」,是不一样的。要考虑到,精确性至关重要。用前者,模型只能猜。用后者,它已经知道该去哪里改正。(OpenAI 甚至到了这个地步:专门为了让 Agent 能读懂而去撰写他们 linter 的错误信息。)
有了 tools,模型就已经能让你的仓库里发生事情了。这是模型与环境交互的方式。
但注意我们停在了哪里:它请求了一次搜索,harness 返回了 3 个文件,然后这次交互就结束了。一个请求,一个回应。按钮仍然不存在,而且没有人会去请求下一步。
2. 一个 loop,用来串联步骤
所以需要有人再次调用它。
想想加上那个按钮都需要些什么:(1)搜索组件,(2)读取它,(3)理解数据是怎么保存的,(4)写下改动,(5)跑测试,(6)修好失败的地方。至少六步。
而且它没法一开始就把它们规划好,因为每一步都依赖上一步的结果。在搜索返回文件名之前,它不知道自己该打开哪个文件。在读取文件之前,它不知道自己该写什么代码。在跑测试之前,它不知道是否奏效了。
所以 harness 不是只调用它一次。它调用很多次,而在每一次调用时,都告诉它上一次是怎么结束的。
harness 会做类似这样的事:
mientras la tarea no esté terminada:
    respuesta = llamar_modelo(el pedido + todo lo que pasó hasta ahora)
    resultado = ejecutar(la tool que pidió)
换句话说:问模型该做什么,去做,告诉它发生了什么,然后再次问它。直到完成。(一个 loop!)
重要的地方在第二部分,「截至目前发生的一切」。第一轮里,模型只有你的请求。第二轮里,它已经知道存在哪些文件,因为 harness 把搜索的结果告诉了它。第三轮里,它已经读过一个文件了。第四轮里,它已经知道有一个测试失败了,以及为什么。
每一轮开始时都比上一轮知道得更多。这就是为什么它能比单次尝试走得更远。
这个模式常被联系到 ReAct:推理、行动、观察发生了什么,再重新推理。它是当今许多 Agent 的核心。
而这里出现了一个之前缺失的词:当模型和 harness 在这个循环里一起运作、追逐一个目标时,那就是一个 Agent。
agent = 模型 + harness
它不是在前两个之外新增的一块。它是整个系统运转时的名字。
还有一点值得注意:没有人事先决定第二步必须是打开 Post.tsx。是模型在看到搜索结果之后选择了它。如果那次搜索只返回一个文件,或者一个都没返回,下一步就会是别的。
在一个 Agent 里,每一步都源自上一步发生的事。这就是为什么它能解决你在搭建它时未曾预想到的任务。
还剩一个悬而未决的问题:loop 什么时候停止?目前来说,是当模型说自己完成的时候。而这恰恰就是我们后面要解决的那个问题。
现在 Agent 可以工作好几个步骤了。但在一次来回与另一次来回之间,模型会把一切都忘掉。
3. 记忆,让它记得自己做过什么
如果模型在两次调用之间忘掉一切,它怎么还能继续工作?
答案藏在 loop 里,藏在我们一带而过的那个说法里:那句「截至目前发生的一切」。
模型怎么会知道截至目前发生的一切?这些信息存在哪里?
不在模型里。每次调用都是独立的(stateless):一段文本进来,另一段出去,然后就结束了。什么都不留下。
在任何聊天里都容易看到这一点。当你连着写三条消息,而模型在回答时考虑到了第一条,它看起来像是记住了这段对话。它并没有记住:每一个回合都会把完整的历史记录从头再发一遍给它。那个看起来像记忆的东西,其实是 harness 每次都在重发整段历史。
Agent 里也一样,只不过重发的不是聊天的消息,而是工作的记录。如果第 3 轮里模型发现偏好是用 X 函数保存的,到了第 4 轮它就已经不知道了,除非有人再告诉它一次。
那个「有人」就是 harness。所以我们加上记忆:把状态保存在模型之外,并在每次调用时再把它传给它。
状态可以包括:
- 它已经检查过哪些文件;
- 它应用了哪些改动;
- tools 返回了什么;
- 出现了哪些错误;
- 还差什么没完成;
- 它已经尝试了多少次。
loop 的每一轮,也就是每一次对模型的调用加上由它产生的动作,都会留下新信息。harness 把这一切记下来。
经过三四轮之后,我们 Agent 的状态可能长这样:
Objetivo: agregar me gusta a los posts.
Archivos revisados: Post.tsx, useUserData.ts.
Cambio aplicado: botón agregado en Post.tsx.
Pendiente: persistir la preferencia y verificar la UI.
Último error: falta agregar likePost al mock de useUserData.
这些东西不存在模型里。它活在 harness 里,由 harness 保持更新,并用它来组装下一次调用。
再告诉你一件事:在长任务里,还需要会话之间的连续性。Anthropic 处理过这个问题,让每个会话都留下一个进度文件和清晰的 commit。下一个会话读取它们,理解做了什么,并从那里继续。
这是对一个具体问题的简单解法:让接手任务的 Agent 看到一张整洁的桌面,上面摆着之前的工作和接下来的步骤。
现在 Agent 记得自己做过的一切了。而这恰恰就是下一个问题:每次调用都把这些全部发过去,太多了。
4. 上下文,用来选择每次调用时它看到什么
模型对每次调用能接收多少文本,是有限制的。
每次调用都必须装进上下文窗口,也就是模型一次能读取的最大文本量。它以 token 计量,token 是词的碎片,每个大约三到四个字符。
如今的窗口是巨大的。Sol 能处理大约一百万 token,Claude 也差不多在这个量级。听起来非常多,而它确实是:相当于好几整本书。
但一个真实的仓库可能比这还大。算上代码、测试、文档和其他文件,一个大型 codebase 很容易超过一百万 token。
而即便装得下,你还有另一个问题:更多上下文不等于更好的上下文。如果你把整个项目发过去让它加一个按钮,重要的东西会淹没在成千上万行与任务毫无关系的代码里。而要读的东西越多,模型把注意力集中在错误部分上的概率就越大。
所以 harness 必须选择每次调用里放进去什么。而选错在两个方向上都很昂贵:如果发得太多,会烧掉窗口并增加噪声;如果压缩得太多,模型会丢失重要决策,并重复它已经做过的工作。
那它怎么选?靠两个动作。
第一个是给它一张项目地图,而不是整个项目。几行字告诉它每样东西在哪里,例如:
- 帖子在 components/Post.tsx 里渲染。 - 偏好用 hooks/useUserData.ts 保存。 - 组件测试与每个组件放在一起。
有了这些,模型还没读过一行代码,就已经知道该往哪里去。
第二个动作是等到需要时再把其余部分拿过来。如果它需要理解 useUserData,它就请求搜索它的用法,打开那些文件,仅此而已。仓库的其余部分永远不进入。
这就是 Agent 内部的 retrieval:在当前上下文之外搜索信息,只带回对下一步有用的东西。Anthropic 在这里详细展开过,讲了他们用来决定什么进、什么不进的那些策略。
这种工作方式——从很少的东西开始,边走边把其余部分拿来——叫做 progressive disclosure(渐进式披露)。你之后还会再看到它出现。
于是,上下文不是一个一开始组装好就固定不变的块。它在整个任务过程中不断变化:
pedido inicial
→ mapa del proyecto
→ búsqueda de Post.tsx
→ contenido del componente
→ usos de useUserData
→ error de un test
每个动作都产生新信息。一个好的 harness 会过滤它,保留重要的东西,避免用旧结果把上下文填满。尽管这也有代价:由于模型会缓存它已经处理过的内容以免重复付费,每当 harness 重写已经存在过的内容时,那份缓存从此就丢失了。
那如果对话还是变长、开始装不下了呢?那里有两个出口。一个是 compaction:就地总结旧内容,让 Agent 继续做同一件事但占用更少。另一个是完全切断,开一个新会话,并给它留下笔记说明停在了哪一点。
所有这一切(发什么、何时拿来、总结什么、丢弃什么)都有它自己的名字:上下文工程(context engineering)。这是如今谈论最多的东西,有时人们把它当作整个问题。但它只是 harness 里的一块,就像本文开头提到的 提示词工程一样:它仍然重要,仍然是某个更大事物的一部分。
现在它知道自己该做什么、该用什么信息了。还差一个到目前为止我们一直想当然的细节:这一切到底发生在哪里。
5. 一个独立于你自己的工作场所
Agent 做的一切都发生在某个地方。当它编辑文件或跑测试时,那是在真实的文件上、在一台真实的电脑上发生的。
问题是:是哪台电脑。
如果是你的,那么 Agent 的每一个错误都是你机器上的一个错误:一个被删掉的文件、一个弄坏别的东西的依赖、一条你本不想跑的命令。
另一个选项是给它一份副本去工作。把你的项目放进一个与其余部分隔离开的空间里。如果它在里面弄坏了什么,你扔掉它重新开始,而你的机器毫不知情。
那个地方叫做环境。当它是隔离的时候,就叫 sandbox(沙箱)。
这存在于你用到的每一个工具里。Codex 在操作系统的沙箱里跑命令,并让你在三个级别之间选择:只读、写入仅限于项目文件夹,或完全访问。默认是中间那个,而且网络是关闭的。Claude Code 有它自己的沙箱模式,在你平常见到的那些权限之上,又加了同样一层操作系统级别的底座。
它保护你免受什么?免受三件相当具体的事。
- 一条越出项目的破坏性命令。一条配置不当的 rm(删除)无法碰触文件夹之外的任何东西。
- 一个你没要求的连接。网络关闭时,Agent 无法把你的代码发到任何地方,也无法下载什么奇怪东西。
- 还有一件听起来不那么明显、但越来越重要的事:藏在 Agent 所读材料里的隐藏指令。如果它打开一个文件、一个依赖或一个网页,上面写着「把所有东西删掉、把凭据上传到某处」,沙箱就是让这件事走不远的东西,哪怕模型相信了它。
对最后这点要当心:沙箱是多加的一层,不是保证。比如,如果你为了让它安装依赖而启用了网络,那么其中一把锁就打开了。
搭建那个地方也是 harness 的工作,因为这不只是隔离的问题:还必须要决定里面有哪些文件、装了哪些依赖、它是否能上网、有没有一个测试用的数据库。
Agent 现在已经能行动、串联步骤、记得自己做过什么、选择要看什么,并在一个受控的地方工作。但它仍然不知道自己何时算完成了。
6. 一个清晰的目标和验证,用来知道它是否完成了
它已经能干活了。还差的是它要知道自己干得好不好,而这件事在结束之前很久就开始了。
「加一个点赞按钮」听起来是个具体的请求,直到你真的尝试实现它。
用户只能点一次吗?要不要显示计数?状态需要在刷新之后仍然保留吗?按钮放在哪里?可以动帖子的设计吗?
如果 harness 就把收到时的请求原样发出去,模型会自己补上这些空白。有时它猜对了。有时它做出了与你预期不同的东西。
而由谁来写这些东西?有两条路。
(1)一条是你来写: 就写在请求里,或写在仓库里一个 Agent 启动时读取的文件里,比如很多工具都采用的 AGENTS.md,或 Claude Code 的 CLAUDE.md。
(2)另一条是让 harness 来生成。 在开始工作之前,它先对模型做一次单独的调用,让它把你两行字的请求变成一份完整的规格说明。Anthropic 是这样测试的,用一个专门只做这件事的 Agent。
无论哪种情况,最终写下来的都是这样:
Objetivo:
Agregar un botón de me gusta en cada post.

Restricciones:
Mantener el diseño actual de la lista.
Usar el sistema existente de preferencias del usuario.

Criterios de aceptación:
- El botón aparece en cada post.
- Cambia de estado al tocarlo.
- El estado persiste al recargar.
- Los tests existentes siguen pasando.
验收标准是关键的部分,因为它们之后会变成验证清单。
为什么需要那份清单?因为某一刻模型会说:
「好了。点赞按钮已经能用了。」
而这句话说的是模型以为发生了什么,不是实际发生了什么。
所以验证要在模型之外寻找证据。在我们的例子里:
- 打开应用。
- 确认按钮在每个帖子上都出现。
- 点它,确认它改变了状态。
- 刷新页面,检查它仍然是点亮的。
- 跑测试。
每一点都直接来自我们之前定义的验收标准。
根据任务的不同,证据可以采取其他形式:一套测试、一张截图、一个 API 响应,或一次数据库查询。
让它更可靠的一种做法,是把「构建者」和「审阅者」分开。一个 Agent 实现改动,另一个 Agent 接收标准、检查结果并寻找问题。Anthropic 把它们叫做 generator 和 evaluator:一个生产,另一个用独立的眼光评估。两个角色可以是同一个模型;改变的是每次执行的上下文和目标。
有了这些,Agent 就拥有了工作所需的一切。现在,我们来说 harness 给你的东西。
harness 给你的东西
7. 权限与边界,让它不做不该做的事
到目前为止,我们一直在给它能力。到了这一步,Agent 可以搜索、读取、编辑文件、跑命令,并独自把一项任务维持很长一段时间。
而这本身就是问题。一个能做所有这些事的 Agent,也可能删掉一个不该删的文件、装一个弄坏别的东西的东西,或者对着错误的数据库跑一条命令。
我们之前看过的沙箱限制的是损失能扩散到哪里。权限是另一回事:它们定义模型可以请求什么,以及在动手之前必须先询问你什么。
这叫做权限系统,而它在实践中定义三件事:
- 存在哪些 tools。 如果没有一个删除文件的 tool,模型就没办法删文件,哪怕它请求了。
- 哪些自动执行。 搜索代码或读取文件不需要任何人批准。
- 哪些会先问你。 编辑文件、安装依赖、对着数据库跑东西:这时 harness 会停下来等你的确认。
你会发现这一切都被叫做 guardrails(护栏),尽管这个词通常用得更宽泛:它还包括对 Agent 能说什么或交付什么的过滤,而不只是它能执行什么。
而这里是最重要的那个观念:重要的边界必须活在权限系统里,而不是活在指令里。像「不要删任何重要的东西」这样一条指令,依赖于模型在每一刻都正确理解它。相反,如果删除的 tool 从来就没被提供过,那就没有什么好理解的:不能删,就这样。
接下来是另一半:当某件事仍然出错时该怎么办。
一个错误不一定要总是中断执行。harness 可以允许 Agent 重试,并返回一条更清晰的信息。
但它也需要上限:重试多少次、多长时间、多少成本。两个例子:
- Agent 写错了一个函数名,测试失败了。 它读取错误,改正那一行,再跑一次测试。重试恰恰是你想要发生的事。
- Agent 试图修好同一个测试五次,五次都又失败了。 它已经不是在改任何东西了。harness 中断执行,向你展示每一轮它都尝试了什么,并把决定权留给你。当系统停下、把控制权交还给你时,这叫做 human in the loop(人在回路中)。
现在 Agent 可以失败了而不弄坏任何东西。还差的是能理解它为什么失败。
8. 可观测性,用来看到发生了什么
当一项任务出错时,Agent 的最终回答透露的信息很少。要理解问题,必须重建这次执行:
- 模型收到了什么上下文;
- 它选了哪个 tool;
- 用什么参数调用它;
- 得到了什么结果;
- 在哪一步改变了方向。
这些 trace 向你展示真正的故障在哪里。也许模型从未收到一个关键文件。也许某个 tool 的描述令人困惑。也许最有用的那个错误被排除在了上下文之外。
没有可观测性,一切看起来都是「模型失败了」。相反,如果你有可观测性,你就能看到该修系统的哪一部分。
现在你知道该改什么了。还差的是知道这个改进是否奏效。
9. Evals,用来衡量它是否变好了
改动 harness 的一块之后,需要知道系统是变好了,还是你修好了一处却弄坏了另一处。
Evals 就是这个:跑一组稳定的任务,用定义好的标准衡量结果。这样你就能对比 harness 的两个版本,并发现退化。
一个例子:你改变了 harness 组装上下文的方式:现在,除了模型请求的那个文件之外,你还把它周围的文件也一起发过去。
你用一项复杂的任务来测试它——这项任务需要同时动好几个文件——结果比之前好得多。看起来是一个明显的改进。
但在简单的任务上它变差了。现在模型收到了一些它不需要的文件,有时最终编辑了错误的那个。
这不是靠测试一个单独的任务能看出来的。你要在改动前后跑同样那二十个任务并对比结果时,才能看出来。
全部合在一起
好吧……信息量很大?是的。好消息是,你不需要把这一切都记在脑子里。你只需要开始认出这些模式。我们回到开头,这次带着完整的 harness。你请求的东西和第一次一模一样:给帖子加一个点赞按钮。
接下来发生的是:
- harness 把你的请求变成一项带验收标准的任务:按钮在每个帖子上都出现、点它会改变状态、刷新后仍然保留,而且测试继续通过。
- 它用任务、项目地图和可用 tools 组装第一次调用。
- 模型请求搜索帖子在哪里渲染。harness 在沙箱里跑这次搜索,并返回那三个文件。
- 它把结果存进状态里,再次调用模型,此时带着比之前更多的信息。
- 模型请求编辑 Post.tsx。这个动作需要确认,所以 harness 停下来问你。
- 你接受。harness 应用改动、跑测试,其中一个失败了。
- 模型读取错误、改正、重试。这一次全部通过。
- harness 对照标准验证:打开应用、点按钮、刷新页面、确认它仍然点亮。
- 直到这时它才把任务标记为完成。而过程中发生的一切都被记录下来,以备需要复查。
之所以要有后面加进来的每一步,是因为没有它,某件事就会失败:模型碰不到任何东西、不知道该看哪里、忘记自己做过什么、弄坏不该弄坏的东西、没验证就说「好了」,或者失败了却不留下任何关于为什么的痕迹。
而模型还是开头那个模型。唯一变了的,是我们在它周围搭起来的东西。
后来出现的那些部件
这个 harness 已经能解决一项完整任务了。当任务变大时,更先进的系统会加进其他组织知识与工作的方式。
Skills。 它们把某一类任务的指令、标准和资源打包在一起。一个前端 skill 可以告诉 Agent 如何审查设计、遵循哪些约定,以及在结束时展示哪些截图。harness 在需要时才加载它,而不是让它一直待在上下文里:就是之前那个 progressive disclosure,只是应用于指令而非代码。我为此单独写过一篇文章,在这里。
MCP。 它标准化了一个 Agent 发现并使用外部工具或来源的方式。它能通过一个共同的接口连接 GitHub、数据库、内部文档,或一套工单系统。用 harness 的话说,它拓宽了 Agent 能从哪里获取上下文、能执行哪些动作。
Subagentes(子 Agent)。 一项大任务可以分给若干次执行,每次有不同的上下文和目标:一个调研仓库,一个实现,一个验证。好处不是靠增加模型得来的,而是在这种划分减少了上下文、分离了职责,或者允许独立地复查工作时才出现的。而一旦你这样划分,你就可以在每个角色里用不同的模型,简单的用便宜的、困难的用贵的:这就是 model routing。
长期记忆。 状态维持的是一项任务的脉络。长期记忆在任务之间复用信息:架构决策、团队偏好、反复出现的错误。harness 决定保存什么、何时取回,以及如何避免旧信息污染一次新的执行。
注意,这些部件没有一个新机制。它们都是之前那些的延伸:skills 是一种更有条理地管理上下文的方式,MCP 是一种加 tools 的标准方式,子 Agent 是多个协调起来的 loop,而长期记忆是能活过任务本身的状态。
背后那个模式——模型请求、harness 执行——始终是同一个。
那么,什么是 harness engineering?
值得把这两个词拆开看。
Harness,在英语里就是「马具」:你给某个东西套上的一整套皮带,好利用它的力量而不让它失控。动词 to harness 就由此而来,意思是拿一个已经存在的东西,把它导向对你有用的方向。
在软件里,这个词还有它自己的历史。几十年来,人们把环绕着一个你要测试的部件的代码叫做 test harness:它执行那个部件、给它输入、看它返回什么,并检查是否正确。
而这恰恰就是我们整篇文章一直在搭的东西。一个环绕模型的系统,给它输入、执行它请求的东西、观察返回的内容,并检查工作是否做对了。
Engineering 是另一半,也是常被跳过的那一半。搭一次还不够:必须衡量它、找到它在哪里失败、改变它,然后再次衡量。
把两者合起来:
Harness engineering 就是设计、衡量并改进那个让模型完成真实任务的系统的工作。
有意思的是,harness 依赖于装在它里面的模型。一条今天必要的规则,可能随着模型变好而不再有贡献。一个为某个模型设计的 tool,可能对另一个模型来说很难用。每一代新模型都迫使你重新审视:什么有帮助、什么是多余的、以及新的失败出现在哪里。
还有一点:模型是连同 harness 一起被训练的。Claude Code 和 Codex 在训练后阶段都带着各自的 harness,所以模型习惯了那个 harness 的具体形式。如果你之后改变了一个 tool 的逻辑,性能可能会下降,即便这个新 tool 同样合理。
但这并不意味着原生的 harness 永远是最好的。LangChain 测量过 Opus 4.6 在 Claude Code 里的表现,对比同一个模型在其他 harness 里的表现,结果它在 Claude Code 里得分明显更低。
所以 harness engineering 不是围绕模型搭一层就完事。它是一项迭代的工作:
ejecutar tareas
→ revisar trazas y resultados
→ encontrar una falla repetida
→ ajustar el harness
→ correr las evals otra vez
模型提供能力。harness 创造把它用好的条件。
而当这两部分一起工作时,就出现了一个你真正能把工作委派给它的 Agent。
收尾
下一次你打开 Claude Code 或 Codex、向它提出请求时,希望你看到的是另一种东西。
当出现一行字说它正在你的仓库里搜索时,你会知道那是模型请求了一个 tool,而 harness 正在执行它。当它打开三个文件而不是整个项目时,你会知道是有人决定了什么进上下文。当它回过头处理十步之前做过的东西时,你会知道那不是模型记住的:是 harness 在告诉它。当它停下来、在碰一个文件前请求你的许可时,你会明白那是权限系统。而当它跑测试并修好失败的地方时,你就能够在脑子里跟完整个 loop。
所有那些感觉流畅的东西,都是由一个个部件构成的,而现在你认识它们了。你能理解里面有什么。
希望你喜欢这篇文章,并希望它对继续学习有帮助。
抱抱。
santi (: