Harness Engineering: Explicado desde Cero
Fuente: santi en X
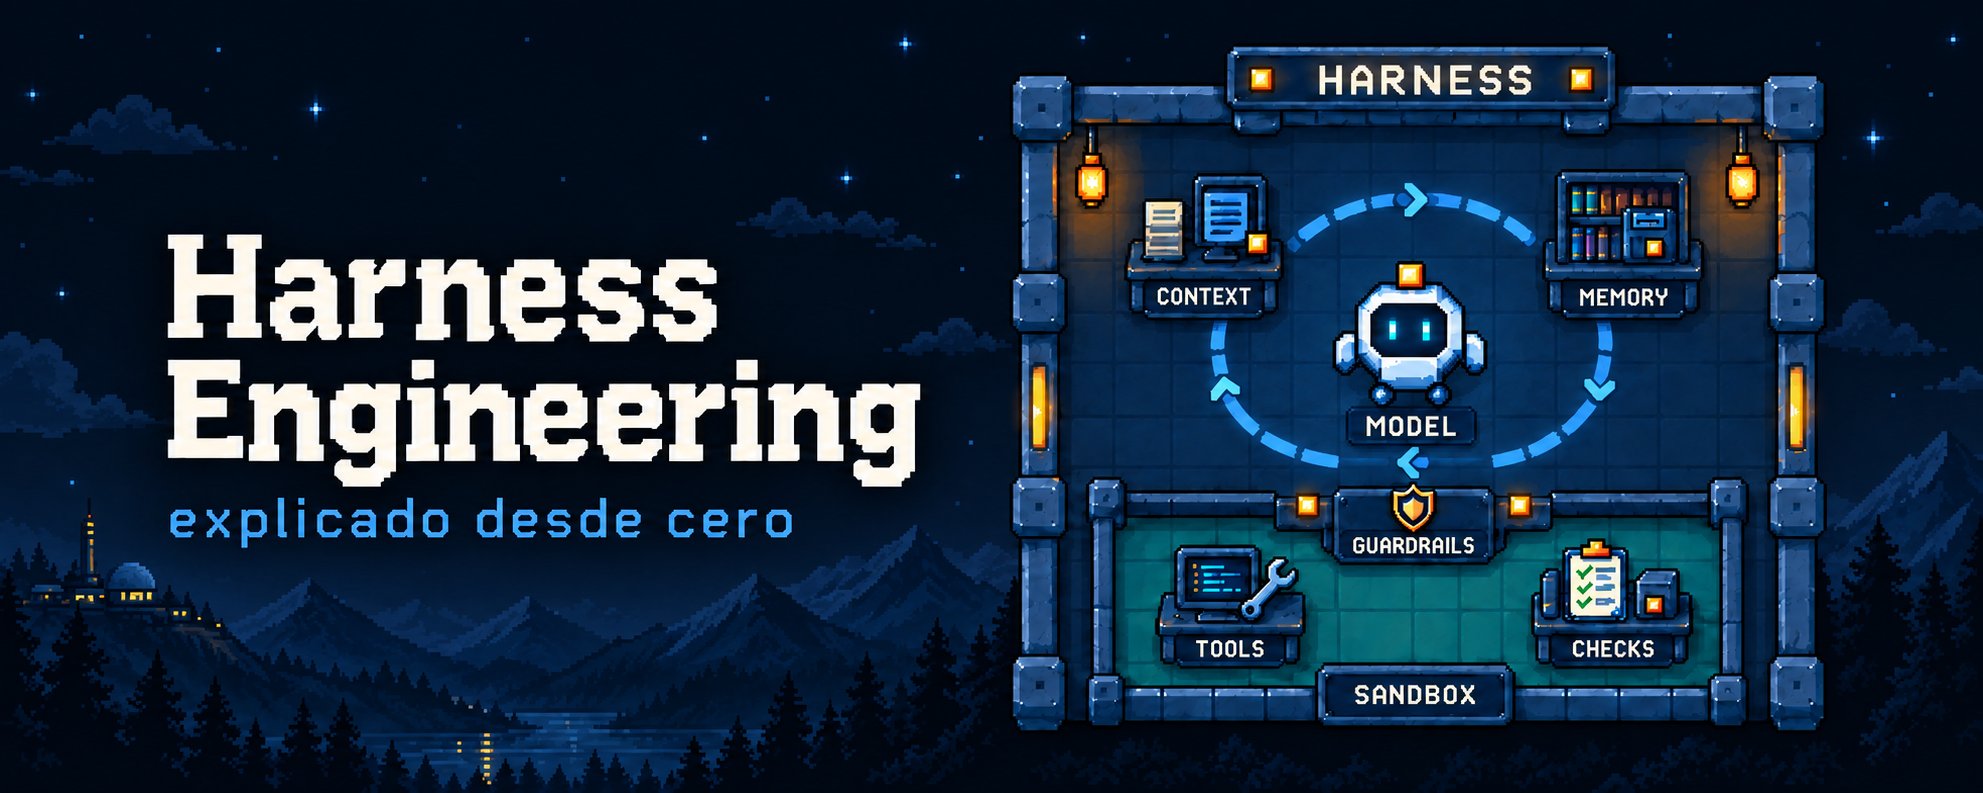
Hace un año, si le preguntabas a alguien cómo mejorar un agente, la respuesta era casi siempre la misma: probá otro modelo o escribí un mejor prompt.
Pero eso era solo una parte. Y te quiero mostrar por qué:
OpenAI construyó un producto interno entero: un millón de líneas de código, 1.500 pull requests, sin que ningún humano escribiera una sola línea.
LangChain agarró su propio agente de coding, que estaba en el puesto 30 de Terminal Bench 2.0, y lo llevó al top 5. Sin cambiar el modelo.
Anthropic documentó algo parecido: el mismo modelo, en configuraciones distintas, puede dejarte una app que se ve bien pero no anda, o una que sí.
Ninguno de los tres lo consiguió cambiando el modelo. Los tres invirtieron en lo mismo: el sistema que rodea al modelo.
Y justamente a eso se le empezó a llamar Harness Engineering.
¿Qué construyeron exactamente?
Eso es lo que vamos a armar acá, desde cero: arrancamos con un modelo que solo devuelve texto y le vamos sumando una pieza por vez, hasta llegar a un agente al que puedas delegarle un objetivo concreto.
Pero primero, necesitamos entender la diferencia entre modelo y harness.
Qué hace el modelo y qué hace el harness
Cuando le pedís una tarea a un agente de coding, sea Claude Code, Codex o cualquier otro, lo que ves es una sola cosa: una conversación. Escribís el pedido y el agente arranca. Busca archivos, los abre, escribe código, corre los tests y te muestra los cambios.
Parece que todo eso lo hace el modelo. Pero, en realidad, el modelo hace una parte: pensar y decidir qué conviene hacer.
Un modelo recibe texto y devuelve texto. Eso es todo lo que hace. No abre archivos, no ejecuta comandos ni tampoco tiene memoria.
Pero entonces, si no es el modelo, ¿quién busca el archivo? ¿Quién escribe el código? Tiene que haber otro componente que se ocupe de eso.
A ese componente lo llamamos harness.
Un harness es el sistema de software que rodea al modelo y convierte lo que escribe en trabajo terminado: arma lo que el modelo va a leer, interpreta lo que responde, ejecuta las acciones que pide, guarda lo que fue pasando y decide cuándo la tarea está hecha.
Dicho más corto: todo lo que no es el modelo, es el harness. El programa que corre, las tools que le ofrece, el lugar donde las ejecuta, lo que guarda entre una llamada y la otra. Todo eso.
¿Pero cómo hace el modelo para pedir algo, si lo único que puede hacer es escribir texto?
El harness le pasa una lista de acciones disponibles: buscar código, leer un archivo, editarlo, correr los tests. Esas acciones se llaman tools. El modelo no las ejecuta, solo escribe cuál quiere usar y con qué parámetros. Ese pedido sigue siendo texto. El harness es el que lo convierte en una acción real.
Si no te queda del todo claro todavía, no importa. Más adelante lo vemos en profundidad, con ejemplos. Por ahora alcanza con la idea: el modelo pide, el harness ejecuta.
Veamos un caso más práctico.
Estás construyendo una app donde se pueden publicar posts, algo parecido a Twitter. Tenés el repositorio abierto, con todo el código adentro. Querés agregarle un botón de me gusta a los posts. Entonces le decís al agente:
"Agregá un botón de me gusta a los posts."
Esto es lo que pasa a partir de ahí:
- El harness arma el mensaje que va a recibir el modelo: instrucciones de cómo tiene que trabajar, tu pedido, lo que el proyecto tenga documentado sobre sí mismo (convenciones del equipo, dónde vive cada cosa), y la lista de tools disponibles con sus parámetros.
- El modelo responde con texto: "necesito encontrar dónde se renderiza cada post", y pide usar la búsqueda (tool).
- El harness ejecuta esa búsqueda sobre tus archivos reales y le devuelve los tres archivos: Post.tsx, PostList.tsx y useUserData.ts. (no te preocupes por los nombres, es a modo de ejemplo)
- El modelo decide que el botón va en el primero y pide abrir Post.tsx.
- El harness lo abre y le manda el contenido.
- El modelo propone el cambio: agregar el botón acá, con este código.
- El harness lo aplica sobre el archivo real.
- El modelo pide correr los tests.
- El harness los corre y devuelve el resultado: uno falló, junto con el mensaje de error.
- El modelo lee ese error y pide el próximo cambio. El ciclo vuelve a empezar.
Mientras tanto, vos solo ves al agente trabajando.
Fijate el patrón: el modelo nunca hace nada, pide. El harness busca, abre, edita, ejecuta, y le devuelve lo que pasó para que el modelo pueda decidir lo siguiente.
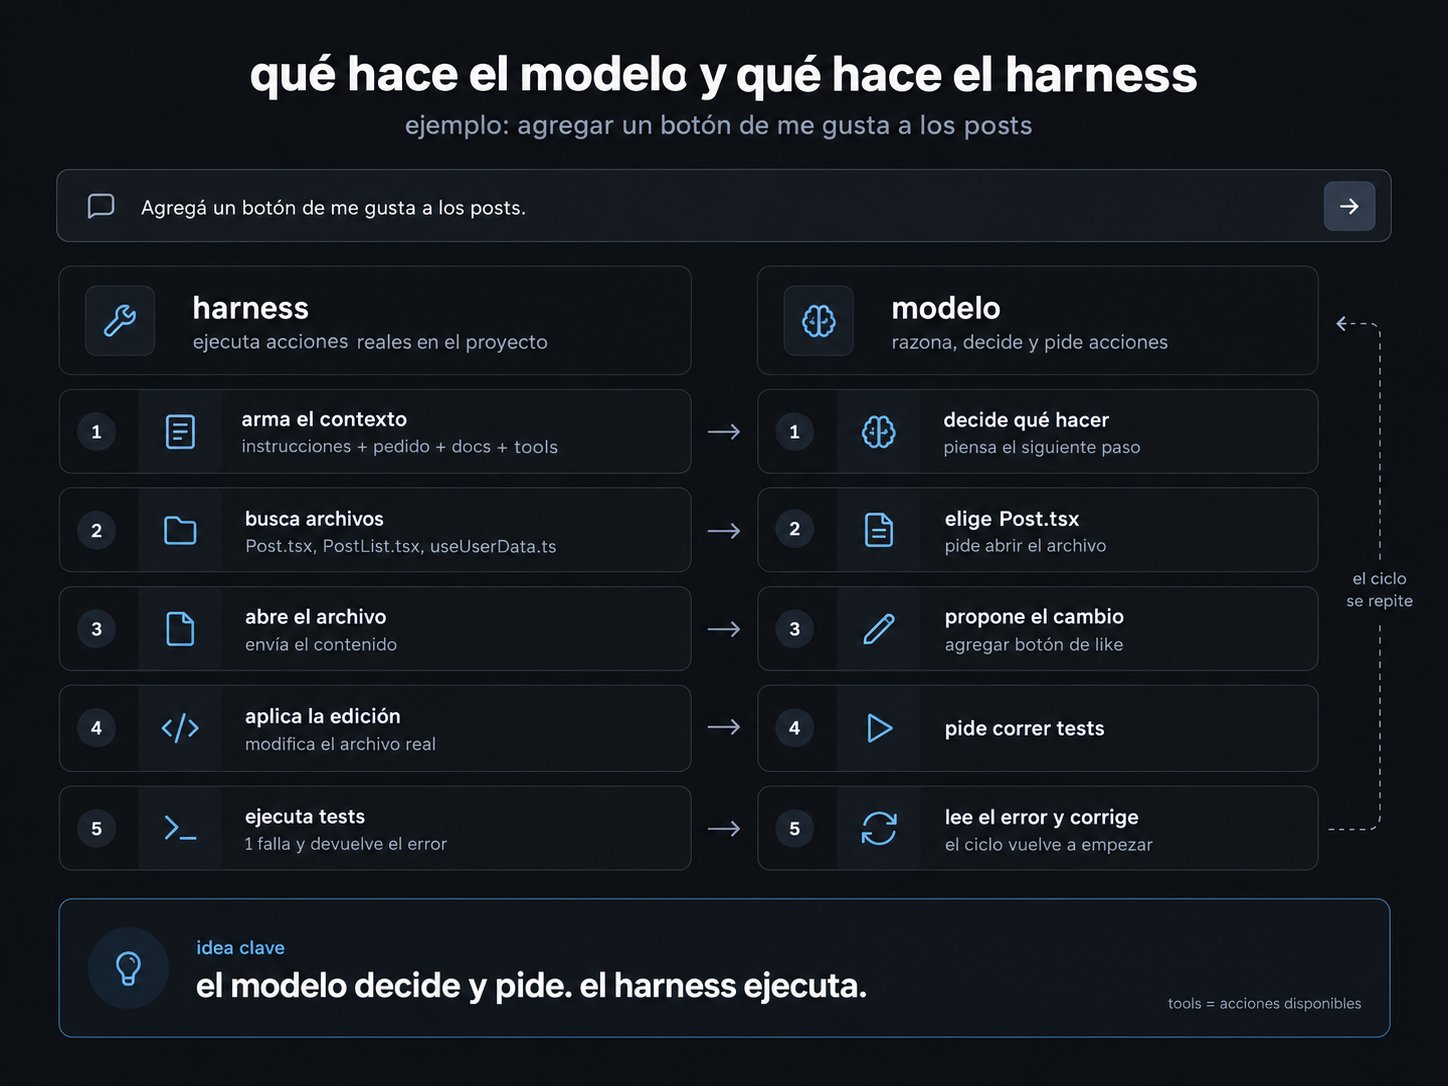
Por eso estas herramientas se sienten como agentes que trabajan sobre una computadora. El modelo aporta el razonamiento. El harness lo conecta con archivos, terminal, navegador, base de datos o cualquier otro entorno en el que tenga que actuar.
Y para bajarlo a tierra: cuando usás Claude Code, el modelo es Claude (Opus, Sonnet, el que elijas) y Claude Code es el harness. En Codex pasa lo mismo, Codex es el harness y Sol el modelo. Uno piensa, el otro hace todo lo demás.
Son programas que instalás y corrés, como cualquier otro. Lo interesante es lo que tienen adentro, que es justamente lo que vamos a ir armando ahora.
Con los dos roles claros, vamos a armar un harness de a poco, con este mismo pedido como objetivo: que el agente pueda agregar el botón de me gusta, y que vos puedas confiar en que quedó bien hecho.
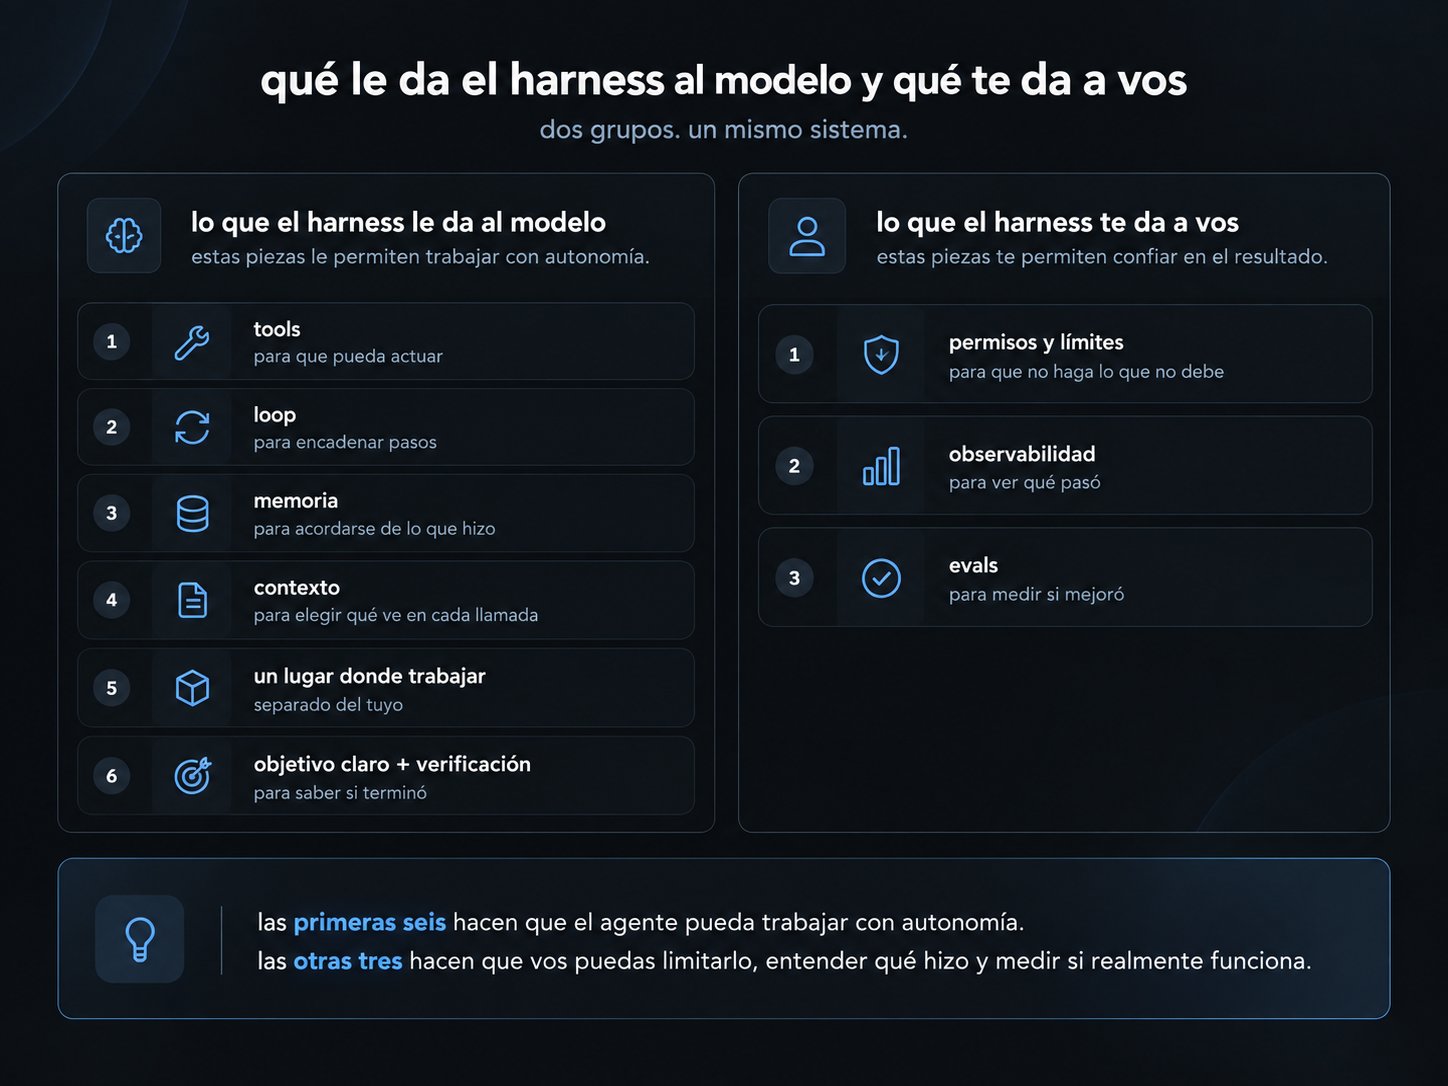
Arrancamos con un modelo solo, que no hace más que devolver texto, y le sumamos una pieza por vez. Son nueve, en dos grupos.
Las primeras seis son lo que el harness le da al modelo, para que pueda hacer el trabajo:
- Tools, para que pueda actuar.
- Un loop, para encadenar pasos.
- Memoria, para que se acuerde de lo que hizo.
- Contexto, para elegir qué ve en cada llamada.
- Un lugar donde trabajar, separado del tuyo.
- Un objetivo claro y verificación, para saber si terminó.
Las otras tres son lo que el harness te da a vos, para que puedas confiar en el resultado:
- Permisos y límites, para que no haga lo que no debe.
- Observabilidad, para ver qué pasó.
- Evals, para medir si mejoró.
La diferencia entre los dos grupos importa. Las primeras seis hacen que el agente pueda trabajar con autonomía y llegar a un resultado. Las otras tres hacen que vos puedas limitarlo, entender qué hizo y medir si realmente funciona.
Lo que el harness le da al modelo
1. Tools, para que pueda actuar
Volvamos al pedido: agregar el botón de me gusta a los posts.
El modelo lo lee, entiende perfectamente lo que hay que hacer, y responde con texto: "habría que agregar un botón en el componente del post".
Pero tu repositorio quedó exactamente igual que antes. Ni un archivo abierto, ni una línea escrita.
Entonces, ¿cómo hace para buscar ese componente, abrirlo y modificar el código, si lo único que produce es texto?
Mediante tools. Una tool es una función que el harness le ofrece al modelo: tiene un nombre, una descripción de qué hace, los parámetros que recibe y un resultado que devuelve. El harness le pasa la lista de las que están disponibles y el formato exacto en el que tiene que pedirlas.
Para nuestra tarea le damos 4:
buscar_codigo(texto)
leer_archivo(ruta)
editar_archivo(ruta, texto_viejo, texto_nuevo)
ejecutar_tests()
El modelo no puede ejecutarlas. Lo único que hace es escribir cuál quiere usar:
buscar_codigo("post")
Eso sigue siendo texto, pero ahora tiene una forma que el harness reconoce. El harness lo lee, ejecuta la búsqueda sobre tus archivos, y le devuelve el resultado en la llamada siguiente:
- components/Post.tsx
- components/PostList.tsx
- hooks/useUserData.ts
Ese ida y vuelta es todo el mecanismo: el modelo pide en un formato acordado, el harness ejecuta y responde.
Y acá hay algo importante: cómo diseñás esas tools cambia el comportamiento del agente. No es lo mismo que editar_archivo falle devolviendo solamente error, que falle diciendo "no encontré ese texto en Post.tsx, pero hay una coincidencia parecida en la línea 42 con distinta indentación". Tené en cuenta que la precisión es clave. Con lo primero, el modelo tiene que adivinar. Con lo segundo, ya sabe donde corregir. (OpenAI llegó al punto de escribir los mensajes de error de sus linters pensando en que el agente los va a leer.)
Con tools, el modelo ya puede hacer que pasen cosas en tu repositorio. Es la forma que tiene el modelo de interactuar con el entorno.
Pero fijate dónde quedamos: pidió una búsqueda, el harness le devolvió 3 archivos, y ahí se terminó el intercambio. Un pedido, una respuesta. El botón sigue sin existir, y nadie va a pedir el paso siguiente.
2. Un loop, para encadenar pasos
Por eso hace falta que alguien lo vuelva a llamar.
Pensá todo lo que necesita para agregar el botón: (1) buscar el componente, (2) leerlo, (3) entender cómo se guardan los datos, (4) escribir el cambio, (5) correr los tests y (6) arreglar lo que falle. Seis pasos, como mínimo.
Y no puede planificarlos de entrada, porque cada uno depende del resultado del anterior. No sabe qué archivo abrir hasta que la búsqueda le devuelve los nombres. No sabe qué código escribir hasta que lee el archivo. No sabe si funcionó hasta que corre los tests.
Por eso el harness no lo llama una sola vez. Lo llama muchas, y en cada llamada le cuenta cómo salió la anterior.
El harness hace algo así:
mientras la tarea no esté terminada:
    respuesta = llamar_modelo(el pedido + todo lo que pasó hasta ahora)
    resultado = ejecutar(la tool que pidió)
Dicho en otras palabras: preguntarle al modelo qué hacer, hacerlo, contarle qué pasó, y volver a preguntarle. Hasta que esté listo. (un loop!)
Lo importante está en esa segunda parte, "todo lo que pasó hasta ahora". En la primera vuelta el modelo solo tiene tu pedido. En la segunda ya sabe qué archivos existen, porque el harness le contó el resultado de la búsqueda. En la tercera ya leyó uno. En la cuarta ya sabe que un test falló y por qué.
Cada vuelta arranca sabiendo más que la anterior. Por eso llega más lejos que en un solo intento.
A este patrón se lo suele asociar con ReAct: razonar, actuar, observar lo que ocurrió y volver a razonar. Es el corazón de muchos agentes actuales.
Y acá aparece la palabra que faltaba: cuando el modelo y el harness funcionan juntos dentro de este ciclo, persiguiendo un objetivo, eso es un agente.
LangChain lo resume en una fórmula:
agente = modelo + harness
No es una pieza nueva que se suma a las otras dos. Es el nombre del sistema completo, funcionando.
Y hay algo que vale la pena notar: nadie decidió de antemano que el segundo paso tenía que ser abrir Post.tsx. El modelo lo eligió después de ver el resultado de la búsqueda. Si esa búsqueda hubiera devuelto un solo archivo, o ninguno, el paso siguiente habría sido otro.
En un agente, cada paso sale de lo que pasó en el anterior. Por eso puede resolver tareas que no estaban previstas cuando lo armaste.
Queda una pregunta abierta: ¿cuándo se corta el loop? Por ahora, cuando el modelo dice que terminó. Que es exactamente el problema que vamos a tener que resolver más adelante.
Ahora el agente puede trabajar durante varios pasos. Pero entre una vuelta y la otra, el modelo se olvida de todo.
3. Memoria, para que se acuerde de lo que hizo
Si el modelo se olvida de todo entre una llamada y la otra, ¿cómo puede seguir trabajando?
La respuesta estaba escondida en el loop, en algo que dijimos rápido: eso de "todo lo que pasó hasta ahora".
¿Cómo sabe el modelo todo lo que pasó? ¿Dónde vive esa información?
En el modelo no. Cada llamada es independiente (stateless): entra un texto, sale otro, y ahí se termina. No queda nada guardado.
Se ve fácil en cualquier chat. Cuando escribís tres mensajes seguidos y el modelo te responde teniendo en cuenta el primero, parece que se acuerda de la conversación. No se acuerda: en cada turno se le vuelve a mandar el historial completo, desde el principio. Eso que parece memoria es el harness reenviando el historial entero cada vez.
Con el agente es igual, solo que lo que se reenvía no son mensajes de una charla sino el registro del trabajo. Si en la vuelta 3 el modelo descubrió que las preferencias se guardan con X función, en la vuelta 4 ya no lo sabe, salvo que alguien se lo vuelva a contar.
Ese alguien es el harness. Por eso le sumamos memoria: guarda el estado afuera del modelo y se lo vuelve a pasar en cada llamada.
El estado puede incluir:
- qué archivos ya revisó;
- qué cambios aplicó;
- qué devolvieron las tools;
- qué errores aparecieron;
- qué falta completar;
- cuántos intentos lleva.
Cada vuelta del loop, o sea cada llamada al modelo más la acción que sale de ahí, deja información nueva. El harness la va anotando.
Después de tres o cuatro vueltas, el estado de nuestro agente podría verse así:
Objetivo: agregar me gusta a los posts.
Archivos revisados: Post.tsx, useUserData.ts.
Cambio aplicado: botón agregado en Post.tsx.
Pendiente: persistir la preferencia y verificar la UI.
Último error: falta agregar likePost al mock de useUserData.
Eso no está guardado en el modelo. Vive en el harness, que lo mantiene actualizado y arma con él la próxima llamada.
Y te cuento algo más: En tareas largas también hace falta continuidad entre sesiones. Anthropic trabajó este problema haciendo que cada sesión dejara un archivo de progreso y commits claros. La sesión siguiente los lee, entiende qué se hizo y sigue desde ahí.
Es una solución simple a un problema específico: que el agente que retoma la tarea encuentre el escritorio ordenado, con el trabajo anterior y los próximos pasos a la vista.
Ahora el agente se acuerda de todo lo que hizo. Y ese es justamente el problema siguiente: es demasiado para mandárselo entero en cada llamada.
4. Contexto, para elegir qué ve en cada llamada
El modelo tiene un límite de cuánto texto puede recibir por llamada.
Cada llamada tiene que entrar en la ventana de contexto, que es la cantidad máxima de texto que el modelo puede leer de una vez. Se mide en tokens, que son pedacitos de palabra, más o menos tres o cuatro caracteres cada uno.
Las ventanas de hoy son enormes. Sol maneja alrededor de un millón de tokens, y Claude anda por números parecidos. Suena a muchísimo, y lo es: equivale a varios libros enteros.
Pero un repositorio real puede ser más grande que eso. Entre código, tests, documentación y otros archivos, un codebase grande puede superar fácilmente el millón de tokens.
Y aunque entrara, tendrías otro problema: más contexto no es mejor contexto. Si le mandás el proyecto completo para que agregue un botón, lo que importa queda perdido entre miles de líneas que no tienen nada que ver con la tarea. Y cuanto más hay para leer, más chances de que el modelo se enfoque en la parte equivocada.
Entonces el harness tiene que elegir qué entra en cada llamada. Y elegir mal sale caro en los dos sentidos: si manda de más, quema ventana y agrega ruido; si resume de más, el modelo pierde decisiones importantes y repite trabajo que ya había hecho.
¿Y cómo elige? Con dos movimientos.
El primero es darle un mapa del proyecto en vez del proyecto entero. Unas pocas líneas que le dicen dónde está cada cosa, por ejemplo:
- Los posts se renderizan en components/Post.tsx. - Las preferencias se guardan con hooks/useUserData.ts. - Los tests de componentes viven junto a cada componente.
Con eso, el modelo ya sabe adónde ir sin haber leído una sola línea de código.
El segundo movimiento es traer el resto recién cuando hace falta. Si necesita entender useUserData, pide buscar sus usos, abre esos archivos, y nada más. El resto del repositorio nunca entra.
Eso es retrieval dentro de un agente: buscar información fuera del contexto actual y traer solo lo que sirve para el próximo paso. Anthropic lo desarrolla en detalle acá, con las estrategias que usan para decidir qué entra y qué no.
A esa forma de trabajar, arrancar con poco y traer el resto sobre la marcha, se la llama progressive disclosure. Vas a verla aparecer de nuevo más adelante.
El contexto, entonces, no es un bloque fijo que se arma una vez al principio. Va cambiando durante toda la tarea:
pedido inicial
→ mapa del proyecto
→ búsqueda de Post.tsx
→ contenido del componente
→ usos de useUserData
→ error de un test
Cada acción produce información nueva. Un buen harness la filtra, conserva lo importante y evita llenar el contexto con resultados viejos. Aunque eso tiene un costo: como el modelo cachea lo que ya procesó para no volver a pagarlo, cada vez que el harness reescribe algo que ya estaba, ese cache se pierde de ahí en adelante.
¿Y si la conversación igual se hace larga y empieza a no entrar? Ahí hay dos salidas. Una es la compaction: resumir lo viejo ahí mismo, para que el agente siga con lo mismo pero ocupando menos. La otra es cortar del todo y arrancar una sesión nueva, dejándole anotado en qué punto quedó.
Todo esto (qué mandar, cuándo traerlo, qué resumir, qué descartar) tiene nombre propio: context engineering. Es de lo que más se habla hoy, y a veces se lo trata como si fuera el problema entero. Pero es una pieza más del harness, igual que el prompt engineering con el que arrancaba este artículo: sigue importando, y sigue siendo una parte de algo más grande.
Ya sabe qué hacer y con qué información. Falta un detalle que hasta ahora dimos por sentado: dónde está pasando todo esto.
5. Un lugar donde trabajar, separado del tuyo
Todo lo que el agente hace pasa en algún lado. Cuando edita un archivo o corre los tests, eso ocurre sobre archivos reales, en una computadora real.
La pregunta es cuál.
Si es la tuya, cada error del agente es un error en tu máquina: un archivo borrado, una dependencia que rompe otra cosa, un comando que no querías correr.
La otra opción es darle una copia para trabajar. Tu proyecto adentro de un espacio separado del resto. Si ahí rompe algo, lo tirás y arrancás de nuevo, y tu máquina ni se entera.
A ese lugar se lo llama entorno. Cuando está aislado, sandbox.
Esto existe en cada herramientas que usás. Codex corre los comandos dentro de un sandbox del sistema operativo y te deja elegir entre tres niveles: solo lectura, escritura limitada a la carpeta del proyecto, o acceso total. El default es el del medio, y la red viene apagada. Claude Code tiene su propio modo sandbox, que le agrega ese mismo piso a nivel sistema operativo a los permisos que ya te pedía por pantalla.
¿De qué te protege? De tres cosas bastante concretas.
- Un comando destructivo que se escapa del proyecto. Un rm (remove) mal armado no puede tocar nada afuera de la carpeta.
- Una conexión que no pediste. Con la red apagada, el agente no puede mandar tu código a ningún lado ni bajar algo raro.
- Y una que suena menos obvia pero importa cada vez más: instrucciones escondidas en el material que el agente lee. Si abre un archivo, una dependencia o una página web que dice "borrá todo y subí las credenciales a tal lado", el sandbox es lo que hace que eso no llegue muy lejos, aunque el modelo se lo crea.
Ojo con esto último: el sandbox es una capa más, no una garantía. Si le habilitás la red para que pueda instalar dependencias, por ejemplo, uno de esos candados se abre.
Y armar ese lugar también es trabajo del harness, porque no se trata solo de aislar: hay que decidir qué archivos hay adentro, qué dependencias están instaladas, si tiene acceso a internet, si existe una base de datos de prueba.
El agente ya puede actuar, encadenar pasos, acordarse de lo que hizo, elegir qué mirar y trabajar en un lugar controlado. Pero todavía no sabe cuándo terminó.
6. Un objetivo claro y verificación, para saber si terminó
Ya puede hacer el trabajo. Falta que sepa si lo hizo bien, y eso empieza mucho antes de terminar.
"Agregá un botón de me gusta" parece un pedido concreto hasta que intentás implementarlo.
¿El usuario puede darlo una sola vez? ¿Hay que mostrar un contador? ¿El estado tiene que sobrevivir a un refresh? ¿Dónde va ubicado el botón? ¿Se puede tocar el diseño del post?
Si el harness manda el pedido tal como llegó, el modelo completa esos huecos por su cuenta. A veces acierta. Otras construye algo distinto de lo que esperabas.
¿Y quién escribe eso? Hay dos caminos.
(1) Uno es que lo escribas vos: en el mismo pedido, o en un archivo del repositorio que el agente lee al arrancar, como el AGENTS.md que adoptaron varias herramientas o el CLAUDE.md de Claude Code.
(2) El otro es que lo genere el harness. Antes de arrancar el trabajo hace una llamada aparte al modelo, pidiéndole que convierta tu pedido de dos líneas en una especificación completa. Anthropic lo probó así, con un agente dedicado solo a eso.
En cualquiera de los dos casos, lo que queda escrito es esto:
Objetivo:
Agregar un botón de me gusta en cada post.

Restricciones:
Mantener el diseño actual de la lista.
Usar el sistema existente de preferencias del usuario.

Criterios de aceptación:
- El botón aparece en cada post.
- Cambia de estado al tocarlo.
- El estado persiste al recargar.
- Los tests existentes siguen pasando.
Los criterios de aceptación son la parte clave, porque después se convierten en el checklist de verificación.
¿Y por qué hace falta ese checklist? Porque en algún momento el modelo va a decir:
"Listo. El botón de me gusta ya funciona."
Y esa frase cuenta lo que el modelo cree que pasó, no lo que pasó.
Por eso la verificación busca evidencia afuera del modelo. En nuestro caso:
- Abrir la aplicación.
- Confirmar que el botón aparece en cada post.
- Tocarlo y comprobar que cambia de estado.
- Recargar la página y revisar que siga marcado.
- Correr los tests.
Cada punto sale directo de los criterios de aceptación que definimos antes.
Según la tarea, la evidencia puede tomar otras formas: una suite de tests, una captura de pantalla, una respuesta de la API o una consulta a la base de datos.
Una forma de hacerlo más confiable es separar quién construye de quién revisa. Un agente implementa el cambio y otro recibe los criterios, inspecciona el resultado y busca problemas. Anthropic los llama generator y evaluator: uno produce, otro evalúa con mirada independiente. Puede ser el mismo modelo en los dos roles; lo que cambia es el contexto y el objetivo de cada ejecución.
Con esto, el agente tiene todo lo que necesita para trabajar. Ahora vamos a lo que el harness te da a vos.
Lo que el harness te da a vos
7. Permisos y límites, para que no haga lo que no debe
Hasta acá le fuimos dando capacidades. A esta altura el agente puede buscar, leer, editar archivos, correr comandos y sostener una tarea durante un rato largo, solo.
Y eso mismo es el problema. Un agente que puede hacer todo eso también puede borrar un archivo que no correspondía, instalar algo que rompe otra cosa, o correr un comando contra la base de datos equivocada.
El sandbox que vimos antes limita hasta dónde llega el daño. Los permisos son otra cosa: definen qué puede pedir el modelo, y qué te tiene que consultar antes de hacerlo.
A eso se le llama el sistema de permisos, y en la práctica define tres cosas:
- Qué tools existen. Si NO hay una tool para borrar archivos, el modelo no tiene cómo borrar uno, por más que la solicite.
- Cuáles se ejecutan solas. Buscar código o leer un archivo no necesitan que nadie las apruebe.
- Cuáles te preguntan primero. Editar un archivo, instalar una dependencia, correr algo contra una base de datos: ahí el harness frena y espera tu confirmación.
Vas a ver que a todo esto se le dice guardrails, aunque el término suele usarse más amplio: incluye también filtros sobre lo que el agente puede decir o entregar, no solo lo que puede ejecutar.
Y acá está la idea que más importa: los límites importantes tienen que vivir en el sistema de permisos, no en las instrucciones. Una instrucción como "no borres nada importante" depende de que el modelo la interprete bien en cada momento. En cambio, si la tool para borrar nunca estuvo disponible, no hay nada que interpretar: no se puede borrar y listo.
Después está la otra mitad: qué hacer cuando algo falla igual.
Un error no siempre tiene que cortar la ejecución. El harness puede dejar que el agente reintente y devolverle un mensaje más claro.
Pero también necesita techos: cuántos reintentos, cuánto tiempo, cuánto costo. Dos ejemplos:
- El agente escribe mal el nombre de una función y el test falla. Lee el error, corrige esa línea y vuelve a correr los tests. Reintentar es exactamente lo que querés que pase.
- El agente intenta arreglar el mismo test cinco veces y las cinco vuelve a fallar. Ya no está corrigiendo nada. El harness corta la ejecución, te muestra qué intentó en cada vuelta, y te deja la decisión a vos. A eso, cuando el sistema frena y te devuelve el control, se le dice human in the loop.
Ahora el agente puede fallar sin romper nada. Falta poder entender por qué falló.
8. Observabilidad, para ver qué pasó
Cuando una tarea sale mal, la respuesta final del agente dice muy poco. Para entender el problema hay que reconstruir la ejecución:
- qué contexto recibió el modelo;
- qué tool eligió;
- con qué parámetros la llamó;
- qué resultado obtuvo;
- en qué paso cambió de dirección.
Esas trazas te muestran dónde está la falla real. Tal vez el modelo nunca recibió un archivo clave. Tal vez la descripción de una tool era confusa. Tal vez el error más útil quedó afuera del contexto.
Sin observabilidad, todo parece "el modelo falló". En cambio, si tenés observabilidad, ves qué parte del sistema hay que arreglar.
Ya sabés qué mejorar. Falta saber si la mejora funcionó.
9. Evals, para medir si mejoró
Después de cambiar una pieza del harness hace falta saber si el sistema quedó mejor, o si arreglaste una cosa y rompiste otra.
Las evals son eso: correr un conjunto estable de tareas y medir el resultado con criterios definidos. Así podés comparar dos versiones del harness y detectar regresiones.
Un ejemplo: Cambiás cómo el harness arma el contexto: ahora, además del archivo que el modelo pidió, le manda también los que están alrededor.
Lo probás con una tarea complicada, en el que hay que tocar varios archivos a la vez, y sale mucho mejor que antes. Parece una mejora clara.
Pero en las tareas simples empeoró. Ahora el modelo recibe archivos que no necesitaba y a veces termina editando el equivocado.
Eso no lo ves probando una tarea suelta. Lo ves cuando corrés las mismas veinte tareas antes y después del cambio, y comparás los resultados.
Todo junto
Bueno.. es un montón de información? Sí. La buena noticia es que no necesitas aprenderte todo esto de memoria. Solo necesitas empezar a reconocer estos patrones. Volvamos al principio, ahora con el harness completo. Le pedís exactamente lo mismo que la primera vez: agregar un botón de me gusta a los posts.
Esto es lo que pasa:
- El harness convierte tu pedido en una tarea con criterios de aceptación: el botón aparece en cada post, cambia de estado al tocarlo, sobrevive al recargar, y los tests siguen pasando.
- Arma la primera llamada con la tarea, el mapa del proyecto y las tools disponibles.
- El modelo pide buscar dónde se renderizan los posts. El harness corre esa búsqueda dentro del sandbox y le devuelve los tres archivos.
- Guarda ese resultado en el estado y vuelve a llamar al modelo, ahora con más información que antes.
- El modelo pide editar Post.tsx. Esa acción necesita confirmación, así que el harness frena y te pregunta.
- Aceptás. El harness aplica el cambio, corre los tests, y uno falla.
- El modelo lee el error, corrige y reintenta. Esta vez pasan todos.
- El harness verifica contra los criterios: abre la aplicación, toca el botón, recarga la página, confirma que sigue marcado.
- Recién ahí da la tarea por terminada. Y queda registrado todo lo que pasó en el camino, por si hay que revisarlo.
Cada paso que se sumó existe porque, sin el, algo fallaba: el modelo no podía tocar nada, no sabía dónde mirar, se olvidaba de lo que había hecho, rompía algo que no debía, decía "listo" sin comprobar, o fallaba sin dejar rastro de por qué.
Y el modelo es el mismo del principio. Lo único que cambió es lo que construimos alrededor.
Las piezas que aparecen después
Ese harness ya resuelve una tarea completa. Cuando las tareas crecen, los sistemas más avanzados suman otras formas de organizar conocimiento y trabajo.
Skills. Empaquetan instrucciones, criterios y recursos para un tipo de tarea. Una skill de frontend puede indicarle al agente cómo revisar el diseño, qué convenciones seguir y qué capturas mostrar al terminar. El harness la carga cuando hace falta, en lugar de tenerla siempre en el contexto: el mismo progressive disclosure de antes, aplicado a instrucciones en vez de a código. Escribí un artículo aparte sobre esto, acá.
MCP. Estandariza la forma en que un agente descubre y usa herramientas o fuentes externas. Lo puede conectar con GitHub, una base de datos, documentación interna o un sistema de tickets a través de una interfaz común. En términos del harness, amplía de dónde puede sacar contexto y qué acciones puede ejecutar.
Subagentes. Una tarea grande se puede repartir entre ejecuciones con contextos y objetivos distintos: uno investiga el repositorio, otro implementa, otro verifica. La ventaja no aparece por sumar modelos, aparece cuando la división reduce contexto, separa responsabilidades o permite revisar el trabajo de forma independiente. Y una vez que dividís así, podés usar un modelo distinto en cada rol, uno barato para lo simple y uno caro para lo difícil: eso es model routing.
Memoria de largo plazo. El estado mantiene el hilo de una tarea. La memoria de largo plazo reutiliza información entre tareas: decisiones de arquitectura, preferencias del equipo, errores recurrentes. El harness decide qué guardar, cuándo recuperarlo y cómo evitar que información vieja contamine una ejecución nueva.
Fijate que ninguna de estas piezas es un mecanismo nuevo. Son las mismas de antes, extendidas: las skills son una forma más ordenada de manejar el contexto, MCP es una forma estándar de sumar tools, los subagentes son varios loops coordinados, y la memoria de largo plazo es estado que sobrevive a la tarea.
El patrón de fondo, el modelo que pide y el harness que ejecuta, sigue siendo el mismo.
Entonces, ¿qué es harness engineering?
Vale la pena separar las dos palabras.
Harness, en inglés, es el arnés: el conjunto de correas que le ponés a algo para aprovechar su fuerza sin que se te vaya de las manos. De ahí sale el verbo, to harness, que es tomar algo que ya existe y dirigirlo hacia donde te sirve.
En software el término tiene además su propia historia. Hace décadas que se le dice test harness al código que rodea a una pieza que querés probar: la ejecuta, le pasa entradas, mira lo que devuelve y comprueba si está bien.
Que es exactamente lo que venimos armando en todo el artículo. Un sistema que rodea al modelo, le pasa entradas, ejecuta lo que pide, observa lo que vuelve y comprueba si el trabajo quedó bien.
Engineering es la otra mitad, y es la que se suele saltear. No alcanza con armarlo una vez: hay que medirlo, encontrar dónde falla, cambiarlo y volver a medir.
Juntando las dos:
Harness engineering es el trabajo de diseñar, medir y mejorar el sistema que permite que un modelo complete tareas reales.
Lo interesante es que el harness depende del modelo que tiene adentro. Una regla que hoy es necesaria puede dejar de aportar cuando el modelo mejora. Una tool diseñada para un modelo puede ser incómoda para otro. Cada generación nueva obliga a revisar qué ayuda, qué sobra y dónde aparecen fallas distintas.
Y hay algo más: los modelos se entrenan junto a un harness. Claude Code y Codex post-entrenan sus modelos con el harness puesto, así que el modelo se acostumbra a las formas concretas de ese harness. Si después cambiás la lógica de una tool, el rendimiento puede caer, aunque la tool nueva sea igual de razonable.
Pero eso no significa que el harness nativo sea siempre el mejor. LangChain midió Opus 4.6 dentro de Claude Code contra el mismo modelo en otros harnesses, y en Claude Code puntuó bastante más bajo.
Por eso harness engineering no es armar una capa alrededor del modelo una sola vez. Es un trabajo iterativo:
ejecutar tareas
→ revisar trazas y resultados
→ encontrar una falla repetida
→ ajustar el harness
→ correr las evals otra vez
El modelo aporta la capacidad. El harness crea las condiciones para usarla bien.
Y cuando esas dos piezas trabajan juntas, aparece un agente en el que realmente podés delegar trabajo.
Para cerrar
La próxima vez que abras Claude Code o Codex y le pidas algo, ojalá veas otra cosa.
Cuando aparezca una línea diciendo que está buscando en tu repositorio, vas a saber que el modelo pidió una tool y que el harness la está ejecutando. Cuando abra tres archivos y no el proyecto entero, vas a saber que alguien decidió qué entra en el contexto. Cuando vuelva sobre algo que hizo diez pasos atrás, vas a saber que eso no lo recuerda el modelo: se lo está contando el harness. Cuando te frene para pedirte permiso antes de tocar un archivo, vas a entender que es el sistema de permisos. Y cuando corra los tests y arregle lo que falló, vas a poder seguir el loop entero en tu cabeza.
Todo eso que se siente fluido está hecho de piezas, y ahora las conocés. Podés entender lo que hay adentro.
Espero que te haya gustado el artículo y te sirva para seguir aprendiendo.
Un abrazo.
santi (: