代码模式:使用 MCP 的更好方式
事实证明,我们一直以来都在用错误的方式使用 MCP。
如今大多数 Agent 使用 MCP 的方式,都是把「工具」直接暴露给 LLM。
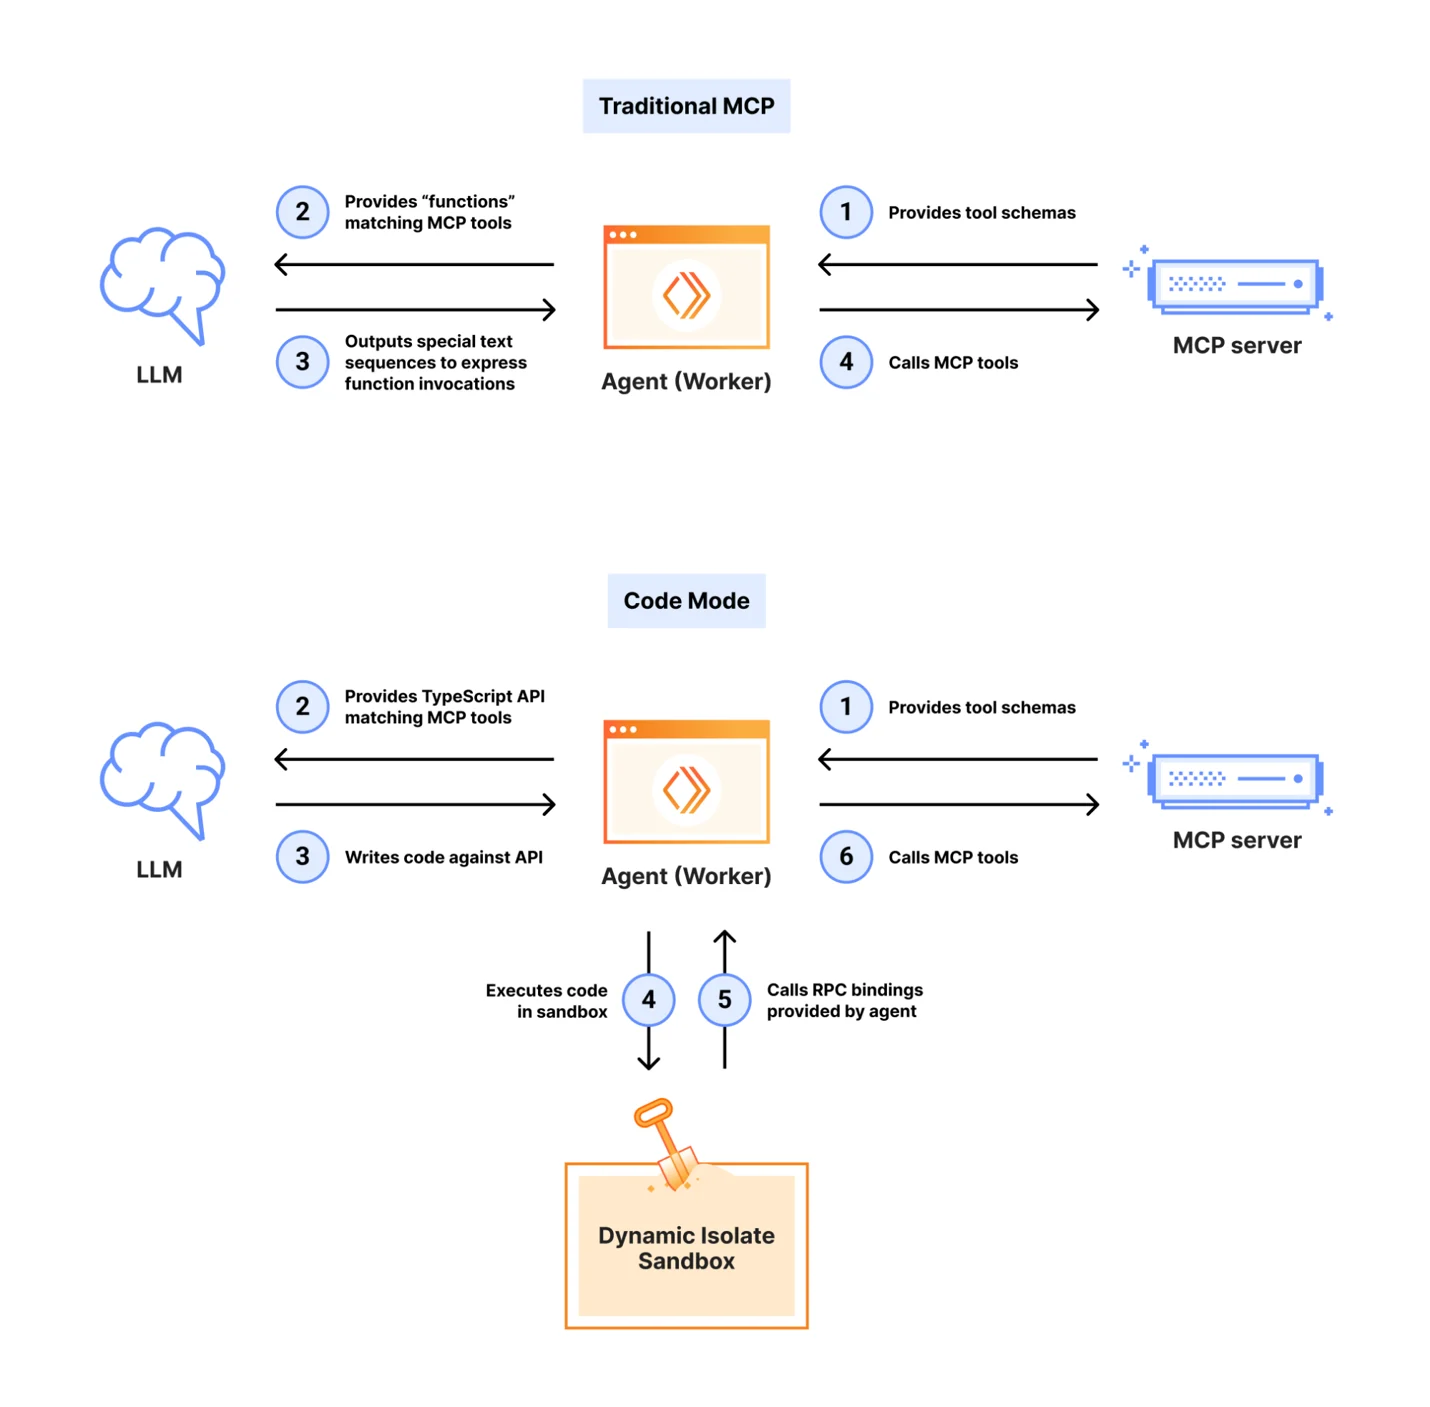
我们尝试了一种不同的做法:把 MCP 工具转换成一个 TypeScript API,然后让 LLM 编写调用该 API 的代码。
结果令人惊讶:
- 我们发现,当工具以 TypeScript API 的形式呈现、而非直接暴露时,Agent 能够处理多得多的工具,以及更复杂的工具。也许这是因为 LLM 的训练集中包含海量的真实世界 TypeScript 代码,而工具调用的示例却只是少量刻意构造的样本。
- 当 Agent 需要把多次调用串联起来时,这种方式的优势尤其明显。在传统方式下,每次工具调用的输出都必须喂回 LLM 的神经网络,仅仅是为了把它复制到下一次调用的输入里,白白浪费了时间、算力和 token。当 LLM 能编写代码时,它就能跳过这一切,只读取它真正需要的最终结果。
简而言之,LLM 更擅长编写代码来调用 MCP,而不是直接调用 MCP。
什么是 MCP?
给还不熟悉的朋友介绍一下:模型上下文协议(Model Context Protocol) 是一种标准协议,用于让 AI Agent 访问外部工具,从而能够直接完成工作,而不仅仅是与你聊天。
换一种角度看,MCP 是一种统一的途径,用来:
- 暴露一个用于做某件事的 API,
- 连同 LLM 理解它所需的文档,
- 而授权则在带外(out-of-band)处理。
在整个 2025 年,MCP 引起了巨大的轰动,因为它突然极大地扩展了 AI Agent 的能力。
MCP 服务器所暴露的「API」被表达为一组「工具」。每个工具本质上就是一个远程过程调用(RPC)函数——它带着一些参数被调用,并返回一个响应。大多数现代 LLM 都具备 使用「工具」的能力(有时称为「函数调用」),也就是说,它们被训练成在想要调用某个工具时,以特定格式输出文本。调用 LLM 的程序会识别这种格式,按指定方式调用该工具,然后把结果作为输入喂回 LLM。
一次工具调用的解剖
在底层,LLM 会生成一串代表其输出的「token」。一个 token 可能代表一个单词、一个音节、某种标点,或者文本的其他组成部分。
然而,一次工具调用涉及一个没有任何文本等价物的 token。LLM 被训练(或者更常见的是被微调)去理解一个它可以输出的特殊 token,其含义是「接下来的内容应被解释为一次工具调用」,以及另一个特殊 token,其含义是「这是工具调用的结束」。在这两个 token 之间,LLM 通常会写出对应某种描述该调用的 JSON 消息的 token。
举例来说,假设你已把一个 Agent 连接到一个提供天气信息的 MCP 服务器,然后你问该 Agent 得克萨斯州奥斯汀的天气怎么样。在底层,LLM 可能会生成如下输出。请注意,这里我们用 <| 和 |> 里的词来代表我们的特殊 token,但实际上,这些 token 根本不代表文本;这里只是为了说明。
I will use the Weather MCP server to find out the weather in Austin, TX.
I will use the Weather MCP server to find out the weather in Austin, TX.

<|tool_call|>
{
  "name": "get_current_weather",
  "arguments": {
    "location": "Austin, TX, USA"
  }
}
<|end_tool_call|>
一旦在输出中看到这些特殊 token,LLM 的 harness(运行时框架)就会把该序列解释为一次工具调用。在看到结束 token 后,harness 会暂停 LLM 的执行。它解析这条 JSON 消息,并将其作为一个结构化 API 结果的独立组成部分返回。调用 LLM API 的 Agent 看到这次工具调用,调用相应的 MCP 服务器,然后把结果送回 LLM API。LLM 的 harness 随后会使用另一组特殊 token,把结果喂回 LLM:
<|tool_result|>
{
  "location": "Austin, TX, USA",
  "temperature": 93,
  "unit": "fahrenheit",
  "conditions": "sunny"
}
<|end_tool_result|>
LLM 读取这些 token 的方式,与它读取用户输入的方式完全相同——区别在于用户无法产生这些特殊 token,因此 LLM 知道这是工具调用的结果。随后,LLM 会像平常一样继续生成输出。
不同的 LLM 可能使用不同的工具调用格式,但基本思路就是这样。
这有什么问题?
工具调用中使用的特殊 token,是 LLM 在真实世界中从未见过的东西。它们必须基于合成的训练数据,被专门训练才会使用工具。而它们在这方面并不总是那么擅长。如果你给一个 LLM 提供过多的工具,或者过于复杂的工具,它可能很难选对工具,或者正确地使用它。因此,MCP 服务器的设计者被鼓励提供大幅简化的 API,相较于他们可能向开发者暴露的更传统的 API。
与此同时,LLM 在编写代码方面正变得非常擅长。事实上,当要求 LLM 针对通常暴露给开发者的完整、复杂 API 编写代码时,它们似乎并没有太大困难。那么,为什么 MCP 接口却要「简化」呢?编写代码和调用工具几乎是同一回事,但看起来 LLM 做其中一件事远比做另一件事更擅长?
答案很简单:LLM 见过大量的代码。它们没有见过大量的「工具调用」。事实上,它们所见过的工具调用,可能仅限于由 LLM 自己的开发者为了训练它而构造的一套刻意设计的数据集。而它们见过的真实世界代码,则来自数以百万计的开源项目。
让 LLM 通过工具调用来完成任务,就像让莎士比亚上一个月的普通话课程,然后要求他用普通话写一部戏剧。这显然不会是他的最佳作品。
但 MCP 仍然有用,因为它统一
MCP 是为工具调用而设计的,但它实际上不必以那种方式被使用。
MCP 服务器所暴露的「工具」,其实只是一个附带文档的 RPC 接口。我们实际上不必把它们呈现为工具。我们可以把这些工具拿来,改成编程语言的 API。
但既然编程语言 API 已经独立存在了,我们为什么要这么做呢?几乎每个 MCP 服务器都只是对某个既有传统 API 的封装——为什么不直接暴露那些 API 呢?
嗯,结果发现 MCP 还做了另一件非常有价值的事:它提供了一种连接并了解某个 API 的统一方式。
即使 Agent 的开发者从未听说过某个特定的 MCP 服务器,而该 MCP 服务器的开发者也从未听说过这个特定的 Agent,AI Agent 依然可以使用这个 MCP 服务器。对传统 API 而言,这在过去很少有这种情况。通常,客户端开发者总是确切地知道自己是在为哪个 API 写代码。结果就是,每个 API 在做诸如基本连通性、授权和文档这类事情时,都可以略有不同。
即使 AI Agent 是在编写代码,这种统一性也很有用。我们希望 AI Agent 运行在一个沙箱中,使其只能访问我们给它的工具。MCP 让 Agent 框架可以做到这一点,它以一种标准方式处理连通性和授权,独立于 AI 代码之外。我们也不希望 AI 为了找文档而去搜索互联网;MCP 直接在协议里提供文档。
好,它是怎么运作的?
我们已经扩展了 Cloudflare Agents SDK 以支持这种新模型!
例如,假设你用 ai-sdk 构建了一个应用,看起来是这样的:
const stream = streamText({
  model: openai("gpt-5"),
  system: "You are a helpful assistant",
  messages: [
    { role: "user", content: "Write a function that adds two numbers" }
  ],
  tools: {
    // tool definitions
  }
})
你可以用 codemode 辅助函数把工具和提示词包起来,然后在你的应用中使用它们:
import { codemode } from "agents/codemode/ai";

const {system, tools} = codemode({
  system: "You are a helpful assistant",
  tools: {
    // tool definitions
  },
  // ...config
})

const stream = streamText({
  model: openai("gpt-5"),
  system,
  tools,
  messages: [
    { role: "user", content: "Write a function that adds two numbers" }
  ]
})
有了这个改动,你的应用现在会开始生成并运行代码,而这些代码本身会去调用你所定义的工具,包括 MCP 服务器在内。我们会在最近为其他库引入对应的变体。阅读文档 了解更多细节和示例。
把 MCP 转换成 TypeScript
当你在「代码模式」下连接一个 MCP 服务器时,Agents SDK 会获取该 MCP 服务器的 schema,然后把它转换成一个 TypeScript API,并根据 schema 附上文档注释。
例如,连接到 https://gitmcp.io/cloudflare/agents 处的 MCP 服务器,会生成如下的 TypeScript 定义:
interface FetchAgentsDocumentationInput {
  [k: string]: unknown;
}
interface FetchAgentsDocumentationOutput {
  [key: string]: any;
}

interface SearchAgentsDocumentationInput {
  /**
   * The search query to find relevant documentation
   */
  query: string;
}
interface SearchAgentsDocumentationOutput {
  [key: string]: any;
}

interface SearchAgentsCodeInput {
  /**
   * The search query to find relevant code files
   */
  query: string;
  /**
   * Page number to retrieve (starting from 1). Each page contains 30
   * results.
   */
  page?: number;
}
interface SearchAgentsCodeOutput {
  [key: string]: any;
}

interface FetchGenericUrlContentInput {
  /**
   * The URL of the document or page to fetch
   */
  url: string;
}
interface FetchGenericUrlContentOutput {
  [key: string]: any;
}

declare const codemode: {
  /**
   * Fetch entire documentation file from GitHub repository:
   * cloudflare/agents. Useful for general questions. Always call
   * this tool first if asked about cloudflare/agents.
   */
  fetch_agents_documentation: (
    input: FetchAgentsDocumentationInput
  ) => Promise<FetchAgentsDocumentationOutput>;

  /**
   * Semantically search within the fetched documentation from
   * GitHub repository: cloudflare/agents. Useful for specific queries.
   */
  search_agents_documentation: (
    input: SearchAgentsDocumentationInput
  ) => Promise<SearchAgentsDocumentationOutput>;

  /**
   * Search for code within the GitHub repository: "cloudflare/agents"
   * using the GitHub Search API (exact match). Returns matching files
   * for you to query further if relevant.
   */
  search_agents_code: (
    input: SearchAgentsCodeInput
  ) => Promise<SearchAgentsCodeOutput>;

  /**
   * Generic tool to fetch content from any absolute URL, respecting
   * robots.txt rules. Use this to retrieve referenced urls (absolute
   * urls) that were mentioned in previously fetched documentation.
   */
  fetch_generic_url_content: (
    input: FetchGenericUrlContentInput
  ) => Promise<FetchGenericUrlContentOutput>;
};
随后,这段 TypeScript 会被加载进 Agent 的上下文。目前,整个 API 都会被加载,但未来的改进可以让 Agent 更动态地搜索和浏览该 API——就像 Agent 化的编码助手那样。
在沙箱中运行代码
我们的 Agent 不会被呈现所有已连接 MCP 服务器的所有工具,而是只被呈现一个工具,它只负责执行某段 TypeScript 代码。
随后,这段代码会在一安全沙箱中执行。该沙箱与互联网完全隔离。它与外部世界唯一的接触通道,就是那些代表其已连接 MCP 服务器的 TypeScript API。
这些 API 由 RPC 调用支撑,会回调到 Agent 循环中。在那里,Agents SDK 会把调用分发到相应的 MCP 服务器。
沙箱中的代码以显而易见的方式把结果返回给 Agent:通过调用 console.log()。当脚本结束时,所有输出日志都会被传回给 Agent。
BLOG-3013 image 1
动态 Worker 加载:这里没有容器
这种新方式需要访问一个能运行任意代码的安全沙箱。那么我们去哪里找呢?我们得运行容器吗?那会很贵吗?
不。这里没有容器。我们有更好的东西:isolate。
Cloudflare Workers 平台一直基于 V8 isolate,也就是由 V8 JavaScript 引擎 驱动的隔离 JavaScript 运行时。
Isolate 比容器轻量得多。 一个 isolate 只需几毫秒就能启动,且只占用几兆字节内存。
Isolate 快得惊人,以至于我们可以为 Agent 运行的每一段代码都创建一个全新的 isolate。无需复用它们。无需预热它们。按需创建,运行代码,然后扔掉。这一切发生得如此之快,以至于开销可以忽略不计;几乎就像你直接 eval() 那段代码一样。但它是安全的。
Worker Loader API
不过,直到现在,Worker 都无法直接加载一个包含任意代码的 isolate。所有 Worker 代码都必须通过 Cloudflare API 上传,然后再全局部署,以便它可以在任何地方运行。这不是我们想要给 Agents 的东西!我们希望代码就在 Agent 所在的地方运行。
为此,我们为 Workers 平台新增了一个 API:Worker Loader API。借助它,你可以按需加载 Worker 代码。它看起来是这样的:
// Gets the Worker with the given ID, creating it if no such Worker exists yet.
let worker = env.LOADER.get(id, async () => {
  // If the Worker does not already exist, this callback is invoked to fetch
  // its code.

  return {
    compatibilityDate: "2025-06-01",

    // Specify the worker's code (module files).
    mainModule: "foo.js",
    modules: {
      "foo.js":
        "export default {\n" +
        "  fetch(req, env, ctx) { return new Response('Hello'); }\n" +
        "}\n",
    },

    // Specify the dynamic Worker's environment (\`env\`).
    env: {
      // It can contain basic serializable data types...
      SOME_NUMBER: 123,

      // ... and bindings back to the parent worker's exported RPC
      // interfaces, using the new \`ctx.exports\` loopback bindings API.
      SOME_RPC_BINDING: ctx.exports.MyBindingImpl({props})
    },

    // Redirect the Worker's \`fetch()\` and \`connect()\` to proxy through
    // the parent worker, to monitor or filter all Internet access. You
    // can also block Internet access completely by passing \`null\`.
    globalOutbound: ctx.exports.OutboundProxy({props}),
  };
});

// Now you can get the Worker's entrypoint and send requests to it.
let defaultEntrypoint = worker.getEntrypoint();
await defaultEntrypoint.fetch("http://example.com");

// You can get non-default entrypoints as well, and specify the
// \`ctx.props\` value to be delivered to the entrypoint.
let someEntrypoint = worker.getEntrypoint("SomeEntrypointClass", {
  props: {someProp: 123}
});
你现在就可以在用 Wrangler 本地运行 workerd 时试用这个 API(查看文档),并且可以注册以获得 beta 访问权限,以便在生产环境中使用它。
Workers 是更好的沙箱
Workers 的设计使其在沙箱化方面异常出色,尤其是对于这个用例,原因有几点:
更快、更便宜、可丢弃的沙箱
Workers 平台使用 isolate 而非容器。 Isolate 要轻量得多,启动也更快。启动一个全新的 isolate 只需几毫秒,而且便宜到我们可以为 Agent 生成的每一段代码都创建一个新的 isolate。无需担心复用 isolate 的池化、预热等等。
我们尚未最终确定 Worker Loader API 的定价,但由于它基于 isolate,我们将能够以比基于容器的方案低得多的成本提供它。
默认隔离,但通过绑定连接
Workers 在处理隔离方面就是更好。
在代码模式中,我们禁止沙箱化的 worker 与互联网通信。全局的 fetch() 和 connect() 函数会抛出错误。
但在大多数平台上,这会是个问题。在大多数平台上,你访问私有资源的方式,是先拥有通用的网络访问权限。然后,利用这种网络访问权限,向特定服务发送请求,并传给它们某种 API key 来授权私有访问。
但 Workers 一直有更好的答案。在 Workers 中,「环境」(env 对象)不只包含字符串,它还包含活对象(live objects),也称为「绑定」(bindings)。这些对象可以直接访问私有资源,而无需涉及通用的网络请求。
在代码模式中,我们让沙箱访问代表其所连接 MCP 服务器的绑定。这样一来,Agent 就能专门访问那些 MCP 服务器,而无需拥有通用的网络访问权限。
通过绑定来限制访问,远比通过诸如网络层过滤或 HTTP 代理来做要干净得多。过滤对 LLM 和监管者来说都很难,因为边界往往不清晰:监管者可能很难确定究竟哪些流量是与 API 通信所正当必需的。与此同时,LLM 也可能难以猜到哪些类型的请求会被拦截。而采用绑定方式,一切都定义明确:绑定提供一个 JavaScript 接口,而该接口是允许被使用的。这样就是更好。
没有 API key 会泄露
绑定的另一个好处是,它们隐藏了 API key。绑定本身提供一个已经授权好的、面向 MCP 服务器的客户端接口。在它之上发起的所有调用都会先经过 Agent 监管者,由监管者持有访问令牌,并把令牌加入到发往 MCP 的请求中。
这意味着 AI 不可能编写出会泄露任何 key 的代码,从而解决了当今 AI 编写的代码中常见的一个安全问题。
现在就试试!
注册生产版 beta
Dynamic Worker Loader API 处于封闭测试阶段。若要在生产环境中使用它,立即注册。
或者本地试用
不过,如果你只是想玩玩,Dynamic Worker Loading 现在在使用 Wrangler 和 workerd 本地开发时已完全可用——查看 Dynamic Worker Loading 和 Agents SDK 中的代码模式 的文档即可上手。